Qiu
我先简单介绍一下,欢迎大家来到无知社的 3 月无知书房,我们和摄影理论避难所一起联合举办的无知书房。我先简单介绍一下两个社群。摄影理论避难所是 2024 年成立的,是一个以摄影理论研讨为起点,但不限于此的开放式社群。无知社是由艺术史博士 Penny 在 2021 年创立的,是专注于全球研究者的跨学科交流社群,我们希望打造一个互相学习、共同分享的社区,同时建立一个开放互助的跨学科智库。我们欢迎来自不同领域、不同阶段的研究者加入,这里的每一位成员都可以发掘新的知识,得到同行的支持,并且分享自己的见解和经验。无知书房是我们无知社每月会举办的读书会活动,每期都会邀请一位不同专业的博士或研究生,围绕特定的主题推荐相关的书籍和电影,带领大家探索不同学科的有趣知识,拓展看待世界的视角。
本次的领读人是 Prismo(陈国森),他是复旦大学哲学博士生,同时也是摄影理论避难所的联合创始人。他在我们无知社春季三棱镜的活动中刚刚分享过关于 AIGC 影像的主题,在本次的无知书房,Prismo 将带领我们探讨人工智能生成影像如何挑战摄影的本质。也非常鼓励大家在分享的过程中可以在聊天框中打字,然后我们在分享结束后会留出一部分时间给大家讨论。
我们就把时间留给 Prismo。
书目介绍
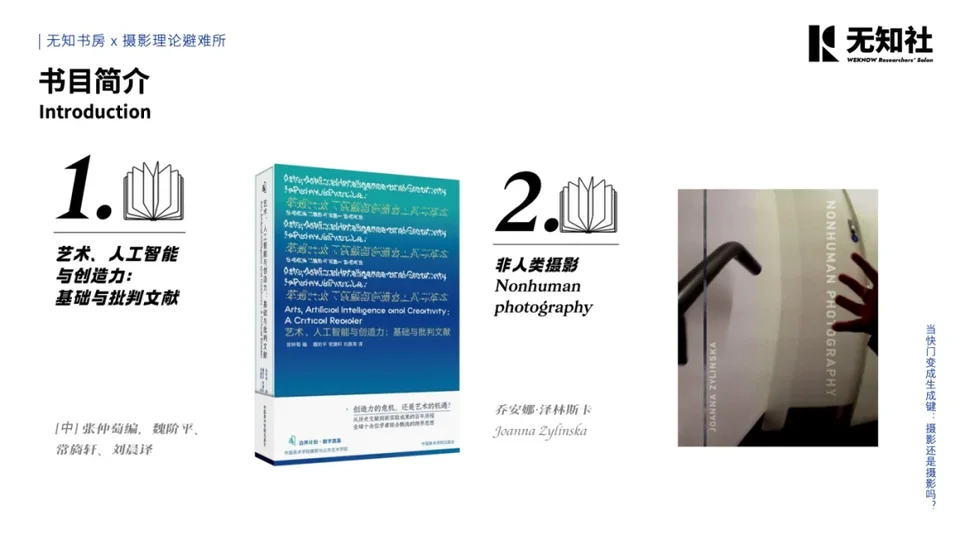
谢谢秋秋,谢谢。我就直接开始我今天的分享,其实算是一个带读的这种尝试,然后跟大家分享一下这个月里面一些我们当时选的一些文献。实际上当时最开始的时候选了 4 本书,还有一本是《艺术、人工智能与创造力》,是一个文集,它里面其实关心的内容基本上跟摄影没有太大关系,属于一个广义意义上对于人工智能和艺术关系之间的探讨,尤其是跟大家着重标里面的几篇,比如说有凯伦·巴拉德的那篇,《后人类主义述行性》。
第二本书比较直接地来讲摄影,但是还没有跟 AI 发生直接的关系,因为这本书是 2017 年出版的,那个时候还没有现在的这种生成式 AI,至少还没有那么大的影响。作者 2023 年出了一本书,叫做《感知机器》(The Perception Machine),那本书里面倒是写到了 GPT 这些内容,但是它可能不是太直接,因为那本书的连续性要建立在她的《非人类摄影》(Nonhuman Photography)之上。
本来我是打算说今天如果有时间的话,跟大家再分享一下第二本书,但是我估计时间还是够呛,因为内容实在是有一点多。所以我今天的分享主要还是放在第三本书上,就是杂志最新的 2024 年《光圈》(Aperture)的冬季刊,讨论的就是人工智能摄影,而且方面涉及到的非常广,并且每一篇文章一般都不是很长。我觉得可能也比较方便大家去讨论,或者是下次再去观看。而且它的文章读起来并没有那么困难,不会像之前第二本、第一本包括第四本有那么强的这种学术性。而且第二本和第四本,他们写作本身也都是蛮有风格的,所以这个也可能会增加一些阅读障碍。
我觉得我之所以推荐那本书,尤其是选了前三章——就说包括序言在内的前三章——其实是为了想让大家去思考:所谓的创造力,这个东西到底能不能拿来给人类摄影的这种独创性或原真性辩护?其实是不可以的。第二本的作者乔安娜·泽林斯卡(Joanna Zylinska),她过两天要来上海讲学,她报的题目就是“非人类的创造力”(nonhuman creativity)。我大概猜到了她要讲什么,大概会用摄影来入手来证明,其实摄影从最开始,它的这种所谓的创造力,从塔尔伯特的《自然之笔》开始,就已经有非人类的属性和非人类的成分在的。而且人类和非人类的创造力并不是一个互相对立的状态,所以这个是我选这本书的原因。
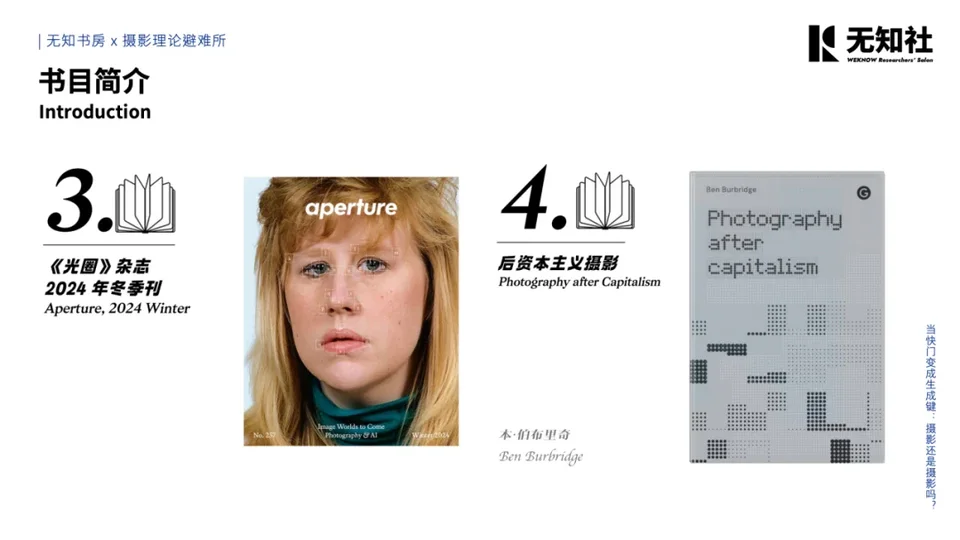
那么更直接去解释现在这个局面,离我们现在最近的这种 AI 摄影的内容,还是要看《光圈》。因为第二本、第四本、第一本都没有直接触及到这个问题,像现在有些生成式 AI 可以直接画出那些和真实照片无异的影像,这种问题,它们还没有直接处理,但是《光圈》杂志里面倒是有多多少少触及到这些问题。
第四本书关注的是隐形劳动、不可见的数字劳动的问题。比如说它里面第一篇文章讲,“谷歌街景司机也是人”。谷歌这种公司对待这种帮他们在城市里面跑测绘、做地图的这些劳工其实很苛刻的。我们现在看到的一些 3D 地图,那些全景的地图,都是由人开着专门的街景车在街上跑、采集数据采集出来的。而且非常有意思的是,他们在招募工人的时候不会挂 Google 的名字,因为为了避免引起注意,他们要把自己真正的雇主隐藏掉。并且有时候还会发布一些通告,告诉工人,这个工作有机会让你去到外地,去做这样的一些测绘和地图信息的采集工作,而且当然是公费旅游——某种意义上——其实他们用了一个小伎俩,等到工人们真正得到这个消息的时候,这种项目的报名日期其实早就已经截止了。而且谷歌其实并不想要真的让这些工人跑到别的地方去帮他们做地图的测绘,谷歌没有给他们上合理的保险,没有规范的福利,之所以要雇佣他们,是因为看中了他们在当地生活的经验和对当地城市的熟悉。所以肯定不可能让他们去外面做这样的地图测绘,对他们来讲经济上是非常不划算的。所以这个是在第一篇文章里面的一个例子。某种程度上。因为现在不管是 AI 也好,还是之前再早一些的这些数字影像也好,它背后的数字劳动很多时候都是被隐藏起来的。
这个问题在我接下来要跟大家分享《光圈》这个杂志里面有触及到,尤其是克劳福德做的“AI 系统的解剖”。之前三棱镜如果有朋友来听的话,当时 Zihan 讲到了这个项目。那么大概 4 本书是这样的一个情况。所以我今天主要的思路还是按照文章来讲,因为《光圈》的每一篇文章的重点可能都不太一样,所以我就没有选择找一个统一的问题,我就按照《光圈》这个杂志的文章顺序,选了几篇比较重要的,跟大家做一个简短的分享。
1. WAYS OF SEEING: Trevor Paglen’s art unravels the politics of computer vision
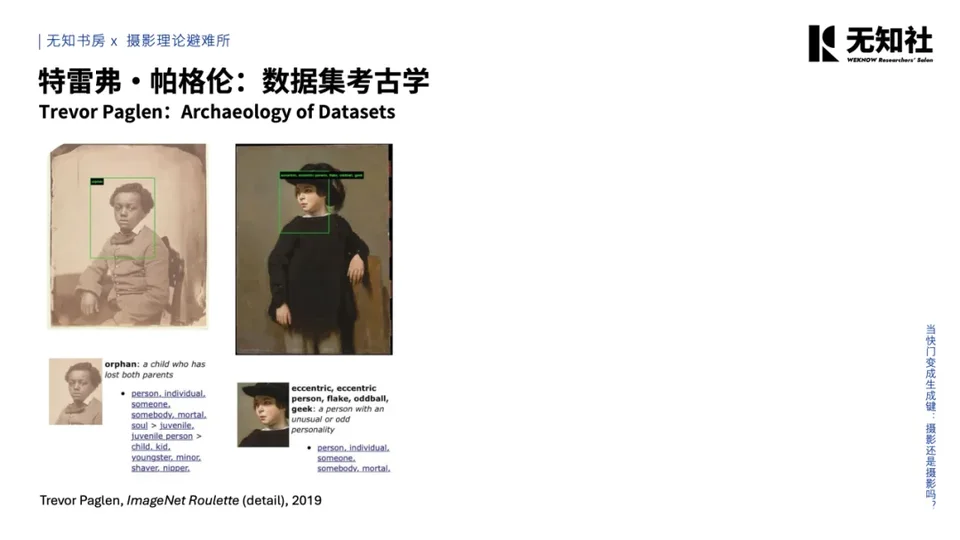
首先是第一篇,也就是封面上,《光圈》这一期的封面用的影像的作者,特雷弗·帕格伦的内容。他其实很早就开始关注人工智能和艺术家如何使用人工智能的这个问题。而且他做这个作品并不只是在关注“我用生成式的 AI 能够生成出什么样子的影像”的问题,而是说:如果说照片本身不再是由人的观看所塑造的,不再是由人所拍摄的,它变成了一个机器自动生成的、判断用的工具的时候,我们在这种情况下如何理解影像?甚至如何学着像机器一样去观看?他在这个脉络上工作已经工作了大概有 10 多年的时间,所以某种意义上来说,他关心的是在生成这样的影像之前,是什么样的条件使得这种生成得以可能的问题。
所以在这个意义上来讲,第一个方面,他从事的工作里面有一部分非常重要的内容,他把它叫做“数据集考古学”。“数据集考古学”这个名字,是在后面另外一篇文章的作者,《代谢影像》的作者克劳福德,跟帕格伦合作的一个项目当中出来的。他们两个人做了一个命名,可能是克劳福德给他的一个命名——数据集考古学。我之前三棱镜的时候有介绍过,也就是说,它挖掘的是 AI 系统被训练的必要材料,就是数据集。而且这些数据集对于没有了解过它们的人来说,可能显得是非常中性、非常所谓客观的一个东西,但是帕格伦做了一个项目,ImageNet Roulette,告诉大家,其实这种数据集里面充满了各种各样的文化偏见,充满各种各样的性别歧视,乃至于暴力。在《光圈》的文章里提到了,帕格伦让观众把自拍上传,然后用 AI 对这些自拍进行分类。而这个地方用到的机器识别,其实就是现实当中的这些监控系统,包括你在边防或者是过关,或者是各种交通要道的地方,遇到了那些具有识别功能的这个机器视觉系统判断人的依据。这是他第一个工作方向:去追溯训练这种生成式 AI 所必需的图像数据集当中隐藏着的各种偏见、各种被人为塑造出来的偏好。
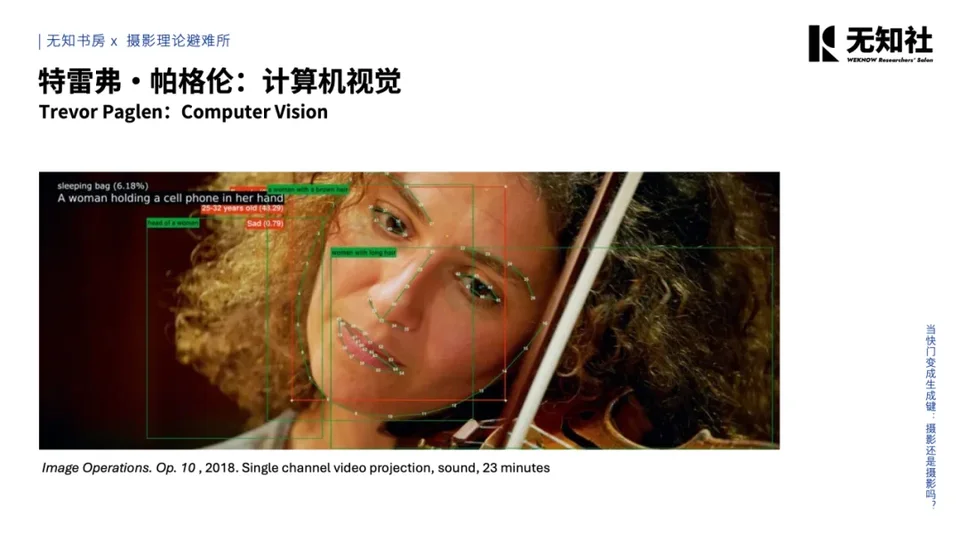
另外一个方向,就是去试着模拟或者追问机器是如何观看的。比如说这一幅截图,或者说这个影片。这是一个视频作品。它让观众去看一段弦乐四重奏,德彪西的弦乐四重奏。随着说音乐慢慢进行,画面会逐渐被这种各种各样的 AI 分析的一个结果取代,在这个过程当中,它会向你展现人的视觉跟机器的视觉之间的区别。慢慢这个画面就变成一些可以量化的、被提取了特征的框架,比如上面标的是这个人的年龄,然后情绪,像这张图里面就显示出了大概是一个 25 到 30 岁的人,然后标着“悲伤”的这样的一个状态。
而在这个意义上来说,这样的系统,它们的判断结果可能有时候会让人觉得荒谬。尤其是在他刚刚那个项目里展现出来的判断结果里。但是问题对于帕格伦来说,问题的关键不在于 AI 判断的准不准,而在于:不管它准不准,这样一种判断和这个结果,都已经作为现在在生活当中对人们的劳动进行管控的工具,作为保障所谓的公共安全的这种算法,所有的这些东西已经在不知不觉当中嵌入到我们日常生活的基础设施里面去了。所以就算它是错误的,它也已经发生了,在现实生活当中带来了一些真实的效果。所以在这个意义上来说,这种影像其实类似于哈伦·法洛基(Harun Farocki)讲的“操作性影像”(operational images),这种影像并不是给人看的,而是作为某种工具,切切实实地在现实的、机器可读的系统里面产生,经由它在其中的流动产生某种对人的实际效果的影像。
而且,帕格伦很少拍那种传统意义上直接摄影的照片,很多时候他喜欢用无人机,包括他会探讨建立卫星地图,包括还会用 AI 生成一些很不对劲的影像。他有一个作品的名字叫做“对抗进化幻觉”,那个是好几年以前做的,也是他自己训练的 AI,然后让他去生成各种各样,比如说吸血鬼的影像,或者说这种看起来有点不正常的那种影像。
“帕格伦使用相机,与其说是为了描绘性的(depictive)目的,不如说是将其作为一种类推(analogy),用以指称“让某物显现”所需的非凡劳动——无论这个“被看见之物”是一个监视无人机,是对我们面部照片所执行的常规计算分析,还是一种操控我们媒介消费的心理战策略。”也就是说,在这个意义上,特雷弗·帕格伦是重新去定义我们现在这个时代摄影到底在做什么。它已经不再是那样一个传统意义上所谓的有一个活人拿着一个相机再去拍另外一个活人这样的行为。事实上,在现在更加主流的一个看法,或者说也是正在崛起的一个意见,认为摄影更适合被定位为某种事件,甚至是某种“潜在的能动者”(potential agent)。不管你拍不拍,不管有没有人再拿相机去摄影,摄影一直都环绕着我们和包围着我们,并且作用在我们身上。因为在各种意义上来讲,人现在感知世界的方式,人在社会生活当中被定位的方式,其实都有那些不由人生产的影像的控制。这个也是第二本书的作者——泽林斯卡,她的新书,2023 年的《感知机器》里面提到的一个观点。当然那个观点有很多来历,不只是她一个人这样讲,像其他的,比如说来自以色列的学者阿莉艾拉·阿伊莎·阿祖莱(Ariella Azoulay),她也有这样的一个看法,在她那本叫做《公民想象力》(Civil Imagination)的书里面也是这样看的。现在西方做摄影的学者,大家更倾向于把它看成是一种包括了生活,并且对我们的生活加以作用的事件,也是一个潜在的、无处不在的事件/实践,而不是由单次的拍摄行动所定义的活动。
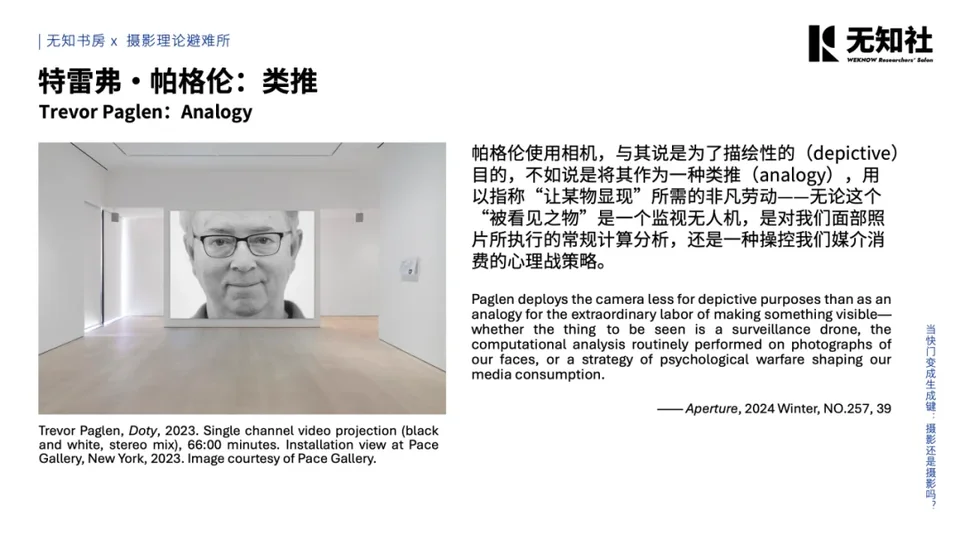
帕格伦对于摄影的判断,是把它当作一种类推。用类推的系统来理解这个东西究竟是如何在我们的现实生活当中运作、被作用到的。左边那个作品,这是一个视频,他做了一个可以说是在真假判断上自相矛盾的东西。这是美国的一个空军官员,但是他在做这个作品的时候他已经不是了。这个人在这个视频里面承认说他做了很多关于 UFO 的假消息,但是他后来又讲说,其实 UFO 也是真的。这个里面,帕格伦就用这种自相矛盾来讲所谓的幻觉,或者所谓的虚假的信息。它是真是假,某种意义上并不重要,重要的是一个假消息如何产生真实的结果,或者说一个幻觉——不管你在什么意义上用的“幻觉”,是说真伪意义上的幻觉,还是说我们在用这个 AI 工具的过程当中,AI 本身产生的这种 hallucination——它会给你带来和真实的消息无异的这种后果,会驱动你去做某件事情。所以他在对谈里面就讲说,某种意义上来说,所有的照片其实都是 UFO 照片。
这是第一篇文章。第一篇文章稍微有点长,留下来的一个问题就是:现在可能到了一个我们需要意识到这件事的节点了 —— 摄影并不是一个必须由人类为主体发出的行为,它甚至很多时候也不以人的直接活动为条件/目的,也并不追求一定要在影像当中去再现一个人物。那么在这个情况下,原来的那种更加偏向于直接性、意涵的摄影认定方法,到底还有多大的力度在帮我们认识现在的摄影?所以对于他来说,影像或者摄影并不是一个技术问题,实际上对他来讲,在技术之前更应当被考虑的是政治,是政治问题。这个政治问题决定了影像如何被运用,决定了影像如何被定义,决定了影像如何被分类。大概就是第一篇对谈 —— 他的论文的第一篇对谈讲到的内容。
2. GENERATIVE STYLE: What FSA photography can teach us about AI
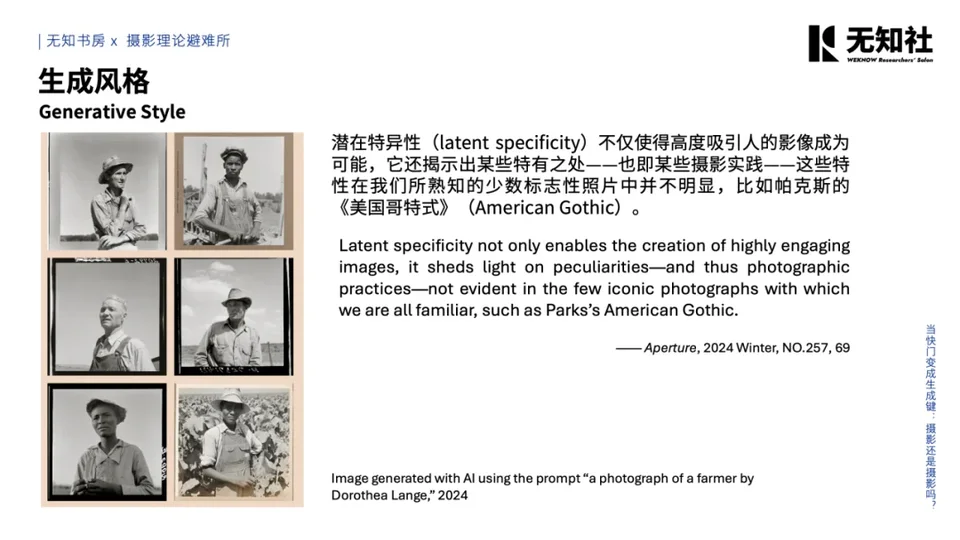
接下来,第二篇文章讲“生成式风格”。也不是在讲影像的真假。作者放了左边的这种——这是利用 AI 生成的多萝西娅·朗格风格的照片。朗格在美国大萧条的时候,还是跟沃克·埃文斯他们那种纪实摄影师齐名的,这些照片其实单凭照片本身去看,基本上很难分辨出来到底是 A I 生成还是多萝西娅·朗格自己拍的。那么也就是说,这一组影像的类似于多萝西娅·朗格的感觉,不是来自于有一个人模仿了朗格的风格去拍摄,而是来自于他们自己微调过的模型。作者把这种性质讲成是一种“潜在特异性”(latent specificity),意思就是说,模型可以通过训练来生成近似某位摄影师风格的影像,但是又不让这张照片跟她现在已有的任何一张照片雷同。而 AI 提取出来的特征,某种意义上它是一个潜在的特征、人无法直接获取的特征,所以作者用了这个“潜在”,但是 AI 学习过的一些数据跟抽象过的权重,又不是传统意义上有光线的反应直接产生的照片。它某种意义上来说是神经网络输出的一种数据的可视化。而摄影,在这个意义上来说,当我们用这个手段去生成照片的时候,其实就只剩下了风格,摄影只剩下了一个可以被模拟、可以被调动的风格。在这种情况下,它生产影像的机制就不像原来一样,我们讲是那种指示性的机制。可以在这个意义上讲,指示性的机制是来自于世界给相机留下的痕迹,但 AI 生成的风格,是在现有的这些影像里面,抽取某些可能人类很难直接提取的潜在的特征,并且再把它们重新组合复现。这也就带来一个什么后果?其实我觉得某种意义上反而会显示出摄影实践的一个状态,就是:如果只是为了某一种风格去创造或者是拍摄的话,那摄影的确会“死亡”。也就是说,如果你去拿着相机拍照片,所有的目的都只是为了拍出像某个大师的照片,某个大师的风格,去学韦伯的风格,或者是像布列松的风格的话,可能它的意义就仅仅剩下了作为体验本身的意义。对于我们来说,你去“拍摄”这个行为本身的体验,它对你来讲当然是有意义的,但是你最后生产出来的照片,可能效果还不如 AI。所以在这个意义上来说,摄影,你其实会发现它其实并不止于影像的生产。我们往往会把“摄影”(photography)跟照片(photograph)做一个等同,但实际上,照片只是摄影流程当中的一个阶段性的结果,它并不能用自己的意义去取代整个摄影的事件或者流程的意义,这是两回事情,而这个事情其实早就存在。这个区别并不是因为 AI 的出现它才得以成立的,只是因为 AI——当 AI 能够无缝地生成某些大师的风格的时候,他甚至能够模仿你自己的照片,生成一件像你自己拍的照片的时候——的出现才更加明确。当这些情况出现的时候,我们认为其实摄影的意义很大程度上,并不能由那一张照片所分泌出来的意义决定。这个时候我觉得这篇很短的“生成式风格”这个文章给大家的一个可以就是有所启发的地方。
3. METABOLIC IMAGES: Is there time to rethink artificial intelligence?
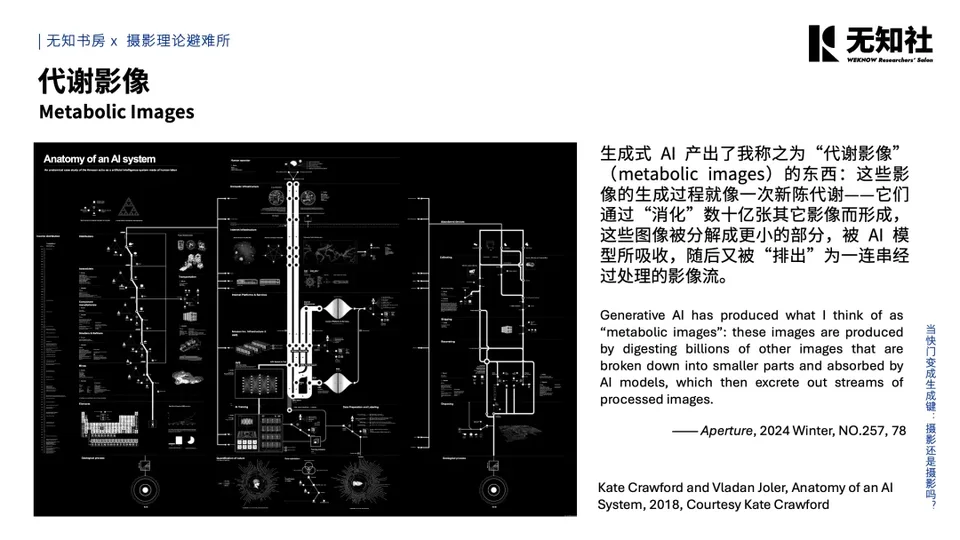
那么接下来这一篇,克劳福德写的“代谢影像”(metabolic images)。代谢影像是什么意思?就是说,这些影像生成的过程,就像人体的新陈代谢一样。首先你吃下一些东西,然后你消化完了之后,大的食物被分解成小的营养物质,然后被 AI 模型吸收掉,吸收掉之后然后接着被排出来,像排泄一样,我们看到的是最后经过排泄的结果。只不过他这篇文章用“代谢影像”讲的,接近于生态问题,生态和资源的问题。
它某种意义上,我觉得在提醒我们注意这样一个事情:经常会听到有人讨论说,AI 如果将来接管人类、或者说不受控了怎么办?疯狂的机器人、疯狂的 AI。但讨论这个事情之前,其实首先要注意到,按照克劳福德的看法,现在的人工智能首先是一种资源密集型的基础设施技术。它不能自己决定自己的“疯狂”。它需要巨大的数据中心,需要巨量的电力,巨大的能源消耗,巨大的用水,还有这种矿物资源。那么在这个意义上来说,AI 消耗的自然资源也属于他讲这个“代谢影像”当中的那些营养。而这种生产其实也对我们来讲并不是一个透明的东西。很少有商业性的公司愿意去谈自己训练这个模型所花费掉的能耗、耗掉的水源诸如此类的,当然倒是很喜欢讲自己用了多少张显卡。那么在这个意义上来说,克劳福德就会讲说,这种影像的生成,它在是美学问题、是文化问题之前,首先是一个生态问题,首先是一个常态问题。所以这个是我说她讲“代谢影像”里面主要的一个意思,一方面它提取的是自然资源,另外一方面提取的是互联网上各种各样的数据,把它拆解成各种颜色标签,然后再转化成模型再吐出来。
在这个意义上来说,“代谢影像”它的运用这个比喻是非常生物性的,那么实际上背后牵扯到的事情也是非常物质的话题,跟书单里的第四本书开头例子里面讲的内容比较相近。因为第四本书里面讲的主要是劳动问题,主要是劳动问题。影像里的劳动如何在影像最终生成之后被抹去,被隐形,被伪装成好像并不存在这种劳动一样。这个也是可以说我觉得像刚刚所讲的对应的物,像是某种意义上一个对应影像,对这 AI 生成的影像,它也并不是一个透明的东西,它有成本,它有自然资源的消耗。
4. GHOSTS IN THE MACHINE: Inside the bizarre world of AI copyright law
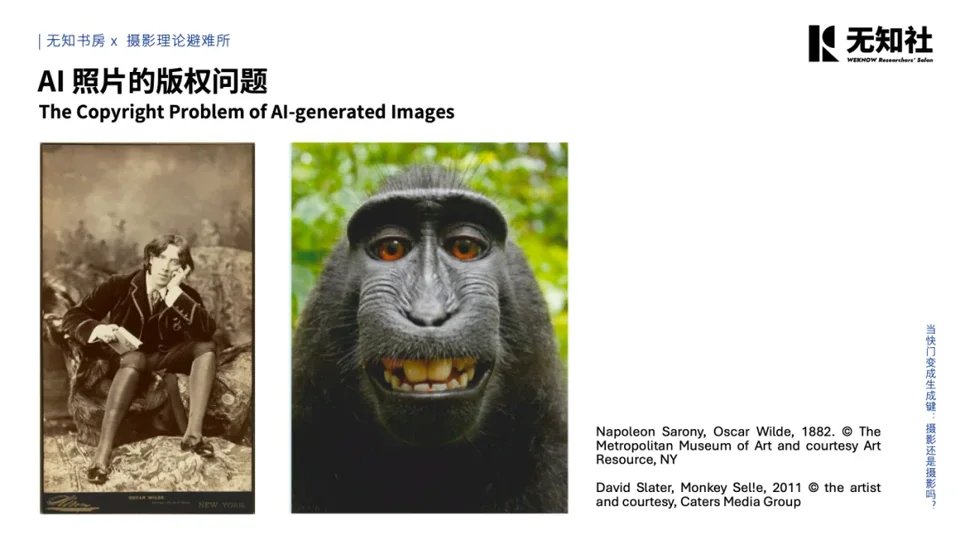
还有接下来一篇小文章讲的 AI 的版权问题。这两天 ChatGPT 更新了生图功能,然后很多人在用它去生成吉卜力工作室风格的影像,包括奥特曼本人。我不知道宫崎骏他们到底怎么对待这个事情,但是也有另外一批声音,觉得这个事情比较不太道德,可能在版权上有一些风险。
这篇文章的作者是学法律的,讨论的问题就是:现在身处 AI 影像到处涌现的这个时代,我们到底应该如何判断作者的归属问题?AI 生成一张照片,作者应该写你,还是应该写你用的模型?他讲了一个例子,就是左边这张,1884 年,摄影师拿破仑·萨罗尼,拍了奥斯卡·王尔德,他最终成功地给这张照片申请到了版权。那么法院把这张照片判定为一个具有原创性的作品。因为他们认为说,这张照片并不是一个机械的复制和再现那么简单,明显体现了摄影师萨拉尼的创造,比如说他布置了瓦尔德的姿势,然后他控制了瓦尔德的表情,他明确了这个光源。所以属于他的创作。所以判例在照片的版权归属上的判例也被沿用到现在,因为对于现在的美国版权局在处理 AI 生成的作品时,似乎仍然是沿着这个思路,如果这个作品里面体现了人的审美判断和创作行为,就可以视为这个人的作品。但是问题在于,你现在再去看这样的一个判例,似乎越来越难适用于现在的这种生成影像的状态。
然后他就举了几个案例,比如说 20 世纪 90 年代的《乌兰蒂亚》案,还有一个就是右边这张“猴子自拍”。一个猴子按下快门拍了一下自己,这个版权到底是猴子的还是人类的?但是法院就讲说,版权只能属于人类,虽然那个过程当中没有人干预,这个只是一个猴子按了一张快门,然后他按了一下快门把自己拍进去了,但是猴子不能成为作者。包括他这篇文章还讲到一个例子,如果你们看原文的话,它讲了用梵高的《星空》的风格生成影像,然后申请版权的时候,版权局就说不行。因为风格融合的过程——就是把梵高的风格挪用到你现在的影像类的过程,是用 AI 做的,而这个作者没有直接控制的一个影像的生成,所以不能这样。这个判断的标准就非常尴尬。很多时候人类确实正在参与这些影像的输入,比如你会写一些提示词,但是法律并不承认这种提示词的创作具有某种创造力——因为创造性的标准,在法律上来讲仍然是来自于 19 世纪的,是我们讲一个艺术家对于他的作品所拥有的这种全局性的控制力。这个东西我觉得在 AI 出现之后,其实越来越成为一种虚构。
很早之前,在 AI 出现之前,其实就已经有学者或者摄影师在指出,这样一种版权观念,甚至于这样一种创造力观念背后的价值取向,实际上是某种“占有性的个人主义”。法律上版权的这种认定,进一步强化了摄影师作为照片的独有者和独享者的地位。问题就在于,摄影并不是一个由摄影师单方面完成的工作。比如说在王尔德这张照片里面,王尔德本人的配合和王尔德本人的形象,同样对于这张照片的形成有极为重要的意义。所以像阿祖莱,像现在包括很多新一代的做视觉文化的学者们,他们开始主张那样一个事情,就是我们并不能够把出现在影像里的被摄者单纯地看作是这种主题,某种 motif,他们实际上也是一个不亚于摄影师的主体。摄影是一个多方参与共同完成的过程,它不能被锚定在由摄影师一个人所决定的这个位置上去。其实是从这个事情也是,我觉得是 AI 出现之后被暴露得越来越明显的一个情况。
而且作者还讲说,我们现在的版权理论之所以处理不了这些问题,是因为他们美国人的问题。这些人判断太过依赖于判例,最终因为 AI 的影像有没有版权也要靠法院看看前面的判例做类比,看有没有一个确定的答案。所以这个文章作者其实最后没有给一个特别明确的我们应该如何去判断 AI 影像的版权问题的答案,他只是把这个问题呈现出来而已。
5. DEEP REALS: What is realism in the age of AI?
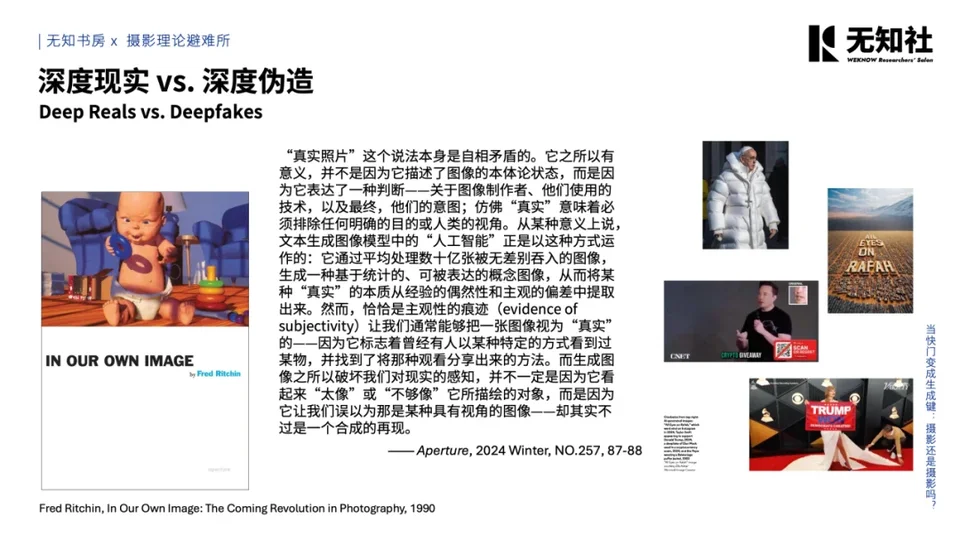
接下来这篇文章我觉得特别有意思,叫做“Deep Reals”。翻译成中文可能翻译成类似于“深度真实”“深度现实”一样的词汇,因为它对应的是另外一个我们现在耳熟能详的现象,就是“Deepfakes”,深度伪造。他问的问题很简单,就是:在这种生成式人工智能的影像到处都是的情况下,我们到底是怎么知道一张照片是不是真实的?因为你看前面那些文章基本上很少谈到影像的真实的问题,帕格伦直接把这个问题悬置掉了,他探讨影像的操作性的效应。可是这篇文章大概是这样的,有点长,我念一下,但是我之所以念是因为我觉得他写的已经很明白了,他用了一个非常口语化的方式去表述,好像不太需要我再做过多的解释。他说:
“真实照片”这个说法本身是自相矛盾的。它之所以有意义,并不是因为它描述了图像的本体论状态,而是因为它表达了一种判断——关于图像制作者、他们使用的技术,以及最终,他们的意图;仿佛“真实”意味着必须排除任何明确的目的或人类的视角。从某种意义上说,文本生成图像模型中的“人工智能”正是以这种方式运作的:它通过平均处理数十亿张被无差别吞入的图像,生成一种基于统计的、可被表达的概念图像,从而将某种“真实”的本质从经验的偶然性和主观的偏差中提取出来。然而,恰恰是主观性的痕迹(evidence of subjectivity)让我们通常能够把一张图像视为“真实”的——因为它标志着曾经有人以某种特定的方式看到过某物,并找到了将那种观看分享出来的方法。而生成图像之所以破坏我们对现实的感知,并不一定是因为它看起来“太像”或“不够像”它所描绘的对象,而是因为它让我们误以为那是某种具有视角的图像——却其实不过是一个合成的再现。
—— Aperture, 2024 Winter, NO.257, 87-88
如果说“真实照片”只是指没有 AI 生成、不是用 AI 生成的影像的话,那它到底是什么?是不是意味着所谓的没有编辑、没有后期的影像就叫真实的?但问题就在于,我们现在所谓的一张影像的真实,很多时候恰恰是因为它体现了某个人的视角,是因为有一个活的人到那儿拍下了这张照片,所以我们把它叫做真实的。否则如果我们认为。“真实影像”是尽量少地受人的主观性干预的影像,才叫“真实”的话,那最真实的反而应该是 AI 影像。这种混淆背后,实际上意味着认为只要技术有介入,我们就应该怀疑它的真实性的看法,这是这种混淆背后的预设。就是说,如果一张照片没有经过技术加工,我们就可以信任它,而这样一种真实观背后,其实遵循的是这种非常简单的预设:你只要有技术介入,比如说 AI 生成、后期篡改,我们就说你是假的;你只要没有技术加工,不管你是怎么去选择,比如说就算有些摄影师刻意通过框取、通过取景把某些可能造成误解的,或者说可能会对理解照片的意义产生颠倒式影响的内容排除在外,但是它没有后期,我们也会说它是真实的。这个看法显然不靠谱。作者也认为,这种预设其实根本已经不成立了。
接下来他又举了好几个例子,比如说就刚刚讲的“AI 生成内容”的标签,Meta 公司在标注 AI 生成内容的时候,不仅标了 AI 生成的影像,还把很多经过后期的照片也归到里面去了。所以就像是一种讽刺:你既然这样搞的话,不如我们把所有的照片都标上,说这个影像并不是真实现实的再现,对吧?因为确实,这句话也是对的,没有任何一张照片符合全方位的整全意义上的现实。所以作者就说,当出现这种情况的时候,我们作为观众,我们以为平台会帮我们判断 AI 内容生成的真假,我们以为说如果是所谓的假照片,平台会给我们标出来,这个时候你自己就会在思维上陷入懒惰,你不会再去辨别影像的来源,不会去辨别它的语境,辨别它的意图。这样一来的话,我们在接受照片的时候,不再像原来一样有一个复杂的解释、感知和判断的过程。
那么他用了另外一本书,就是里钦的书,做了一个类比。因为里钦写这本书的时候,那个时候 Photoshop 刚刚出现,就说我们传统意义上那种“有图有真相”的判断,就是把影像——照片——当做是事实的证据的信念,就已经在被动摇了。现在当然你看这种动摇更加彻底。里钦刚出了一本新书,叫做《合成之眼》,是把这个问题现在又往前推进了一步。
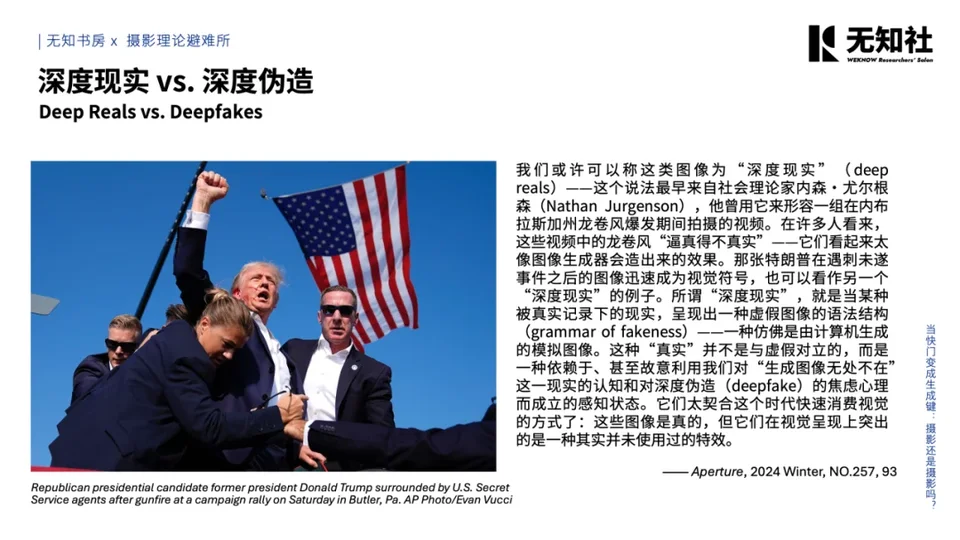
不过讲完这个事情之后,作者又把这个现象往下推了一步,他现在开始讨论另外一个问题,就是怎么认识“realism” 的问题。写实主义和现实主义的范畴现在发生了变化,他提出了一个新的维度来重新思考这个问题。以前我们所说的照片是真实的,我们好像讲的是它记录了现实当中发生的事实,记录了一些 facts。但是现在一张影像——如果说一张照片被当成是真实的,似乎往往是因为它在情感上打动了我们,它帮助我们在社会生活上、在传播上形成某种共识,某种共同的信念。所以他用这样一种现象来区分:“Deepfakes”——深度伪造,是用计算手段去造一个假的影像,并且让它看起来像人拍出来的那种东西,或者人都能制作出来的东西,来欺骗观众。它的运作逻辑就是,你会把所谓的深度伪造的影像当成是现实的记录,当成事实的记录,如果你信任了它,它就成功了。所以它要藏起算法的痕迹,它要伪装成人类做出来的照片或者是影像。但是在这个意义上的“Deep Reals”,指的是那些真正被拍下来的、并不是由 AI 做出来的这个影像(比如说有一些自然灾害,有些新闻现场有重大的事件),但由于这些照片实在是太典型了,太精致了,太所谓的那种缺少一些现实当中的随机感的那种感觉,以至于你会怀疑,你这个照片到底是不是 AI 做的。然后他就举了这个例子,特朗普遇刺的时候,埃文·武奇拍的这一张、在构图上非常类似于自由女神像的这张照片、似乎很像一个 AI 渲染出来的照片。你知道它是真的,但是你直觉上确实感觉总是觉得,这张照片实在太完美了,反而像是 AI 生成出来的。所以他用“Deep Reals”这个词讲的是,在各种各样经过伪造的影像流行的状态下,现实世界里面来自事实的照片,反而看起来会被当成是深度伪造的对象来看待。而它所依靠的这种真实感,已经跟原来的影像产生的那种索引式的、指示性的逻辑相去甚远。我们不是说因为它记录了什么东西来相信它说是真的,而是根据它长得像那些我们之前看过的、我们愿意传播的东西来判断它还是真的。 “Deep Reals”这个词讲的是对于真实感的重新构造。由于 AI 的出现改变了我们对于何为真实影像的感觉,不管这个影像是不是真的,在你判断它的时候都已经加入了对于 AI 影像的参照这个维度,就说明你已经无法脱离生成式 AI 影像的视觉逻辑去看,哪怕是所谓真实的事物。这个就是现在围绕现实主义或者写实主义这个范畴出现的一个新的变种。
6. THE SIMULATED CAMERA: Documentary photography
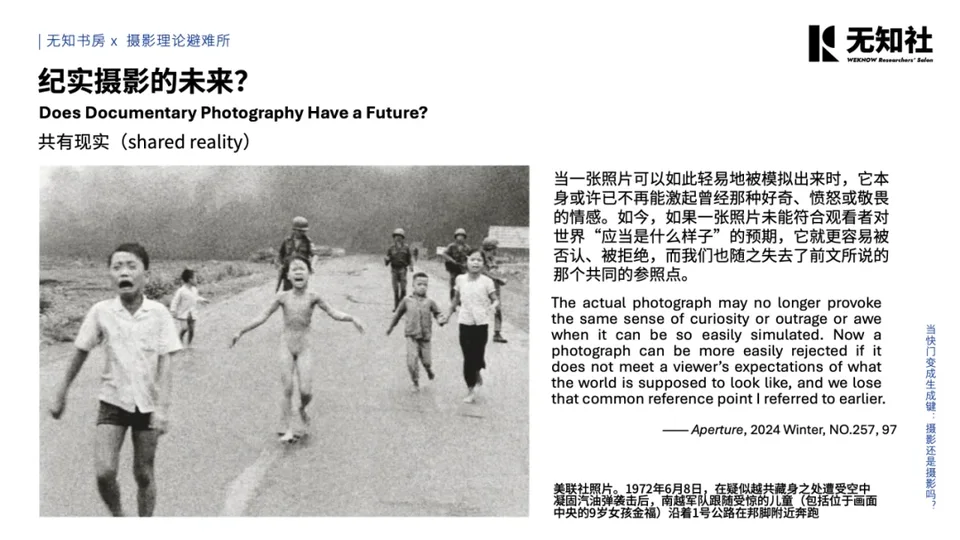
接下来这一篇某种意义上跟上面这一篇是连着的,我觉得他们讨论的问题是有非常大的连续性。里钦的对谈基本上是揭示了真假之辨的判断,但是没有直接去讨论说,什么样的影像可以或者应当被判断成假的,而是说,传统的那种真实影像带来的结果,在今天有没有得到变化,或者有没有被改变?因为对于里钦来说,摄影的作用,是来自一种让我们能够具备某种对于现实的共同认识的机制的,就是他所谓的“共有现实”(shared reality)。
那么这一篇对谈的核心问题就是,现在生成式的人工智能已经无处不在、深度地介入到了世界文化当中的时候,传统意义上依靠直接摄影的这种纪实摄影,还有没有继续存在的必要?那么如果有的话,为什么?而在对谈里面,里钦他基本上从一开始就放弃了所谓的“纪实摄影之死”或者“摄影的死亡”这种陈词滥调,因为这些东西从摄影发明之初基本上就从来没断过。你去看这些评论家去评论摄影的历史,基本上隔那么个十几年二十几年,摄影就要死一次,到现在你会发现,它其实仍然没有死掉,只不过这个“摄影之死”变成了一个新的陈词滥调。
里钦关注的是:我们现在还有没有可能重新建立对于摄影照片作为证据的信任感?因为他说的很清楚,照片或者说摄影,从来不是因为它代表了某种天然的事实才重要的,而是因为它曾经在历史进程当中,在某些至关重要的时刻当中,被人们用来让某些必须被大家看到的事物或者事情变得可见,从而基于这种可见性引起这个群体性的、集体性的回应。是因为这个才显得重要。就是说,我们能够共同确证,在我们自己生存的、我们大家所共在的一个世界里面,真的有某些事情发生过了,这些事情的发生是我们所有人都无法否认的。于是基于这样的一个信念,我们联合在一起了,我们有了对于我们共处其中的“现实”(reality)的信念和认识。他举了一些例子来说明这一点,比如说这张,是 1972 年的时候,小女孩金富被凝固汽油弹烧伤奔跑的影像,另外还有 2015 年叙利亚的一个小男孩倒在沙滩上的一个影像,这里没放。
这些照片之所以对于里钦来讲很重要,不是因为它们展现苦难,或者说不是因为它们展现了战争的残酷,而是因为它给我们所有人提供了一个可以拿来当做我们共同讨论、共同争论,甚至于基于这样一个影像要呈现给我们的状态,去做出集体和共同的回应的参照点。就像亚当斯拍的《西贡枪决》一样,虽然在传播的过程当中,照片的意义被做了一个非常直觉化的曲解,导致警察局长受到了非常不公正的待遇,但是某种意义上,这张照片也给大家提供了一个共有的现实,让美国加快了越战进程的结束,它基本上可以说改变了越战的进程。这个是李琴捍卫他去捍卫纪实摄影的用意。因为今天的很多照片或者影像,已经可以说,它在生产的时候完全不需要相机,你也不需要有观众。比如说 AI,你只需要写一个提示词,马上就可以出现一个看起来是这样的照片,但是它没有办法像传统的纪实摄影那样,提供给我们一个对于我们所共有的现实究竟是什么样子的认识。所以在这种情况下,“照片”这个词本身的含义其实已经变得模糊了。这张照片,或者说这种看起来像照片的东西,背后存不存在一个可供我们去验证的拍摄的事实,存不存在那样一个真实的被摄事件。
而且里钦特别提醒说,现在很多媒体会用所谓“人工智能生成的照片”这种表述,他觉得这是一个偷换概念的说法。其实我也是基本上我也这么认为,虽然很多时候我不得不这样去用,因为“照片”这个词本身,它原本应当是跟某些现场的特定性、某种见证的机制,以及某种 —— 就像上面那篇文章讲到的,有某个人曾经到这个地方拍下来的照片 —— 指示性逻辑绑在一起的。而如果说我们把“照片”这个词过分泛化,甚至用它来指定一些 AI 生成的看起来像照片的影像的时候,摄影的这一套公共机制,摄影这一套建立起我们对于共有现实之认识的机制,就有被瓦解的风险了。
在这个基础上,他就提了一个问题:如果所有的影像都可以被生成的话 —— 就像之前我们看这里面的影像,多萝西娅·朗格的照片都可以这么轻易地被人模仿 —— 那么我们今天如何重新捍卫或者重新定义“纪实摄影”?他用了一个非常古早的一个框架,就是来自约翰·伯格(John Berger)的“引用”(quotation)或者说“引述”。这个说法其实我觉得跟现在比较通用的用“index”——就是索引或者指示符——来界定照片的方式很像。指示符指的是什么?比如说你看到烟,你会知道有火,在这种情况下烟就是火的指示符;你看到脚印,你会知道有人在这儿走过,那脚印就是脚的指示符。它们彼此之间是有明确的物理因果联系的,有照片,那么一定有光,还有这样的光落在感光镜头上。引申一下,就是真的有这样的人站在你的镜头前面。
里钦引用了约翰·伯格的一个讲法,认为摄影实际上是对于现实的表象的一个“引用”。镜头就是引号,拍下来的东西就是引号里面的东西,要明确了引号的范围。而任何超出这个边界的构造,哪怕你的出发点是好的,也不能把它当作纪实摄影。它明确了一个非常明确的边界,必须是来自于现实的“表象”。强调表象是因为,我们不能说有某个人拍出了现实的“本质”,我觉得这个想法也是荒谬的,所以他也特别强调,一定是“appearance”,来自于表象的引用。里钦之所以讲规范、讲引号的边界,实际上是来自于一个伦理上的要求。如果说纪实摄影能够在社会生活和公共生活里面发挥作用的话,或者说我们仍然想让它继续发挥作用的话,那就必须捍卫它仍然能够给大家提供这种共有现实的能力。如果这样一个基础,或者说这种能力都不再可信的话,你的公共讨论可能会出现一些信任危机。
而在这种情况下,他也不是把人工智能当成敌人。他也给了一些比较建设性的例子。比如说那些在战争里面被关押起来的人,或者摄影师,因为什么情况不能到战争的现场,但确确实实有暴力发生过,比如有虐囚的现象,有囚犯遭到虐待的现象,他认可说这种情况可以用 AI 去进行一个生成,来给这些曾经发生、但是没有人见证的时刻,提供一个视觉的一种可视化。而在这种情况下,AI 也可以用来做技术性的工作,来填充那些没有办法真实真正被拍摄的部分,但前提是——里钦说,你必须得明确引号的范围,也就是你得说明这个照片是怎么来的,你要给出足够的语境上、背景上的说明。
在对话的后半段,弗雷德·帕尔默又提了一个非常犀利的问题,他问里钦说,如果 AI 现在可以伪造一切影像,可以去模拟任何的场景,可以去复制任何一张脸,我们到底还有什么办法去判断这张照片到底是在重现曾经的某种事实,还是说在基于某些偏见进行创造?然后帕尔默举了个例子,就是他有一次在伊拉克,一个新闻杂志的编辑打电话问他,刚刚有一起公交车爆炸的事件,问他拍到没有。但实际上大他如果要赶到公交车爆炸的地方,起码得 8 个多小时。杂志社问他拍没拍到。这个照片肯定没拍到。但是他其实可以用 AI 生成照片。当影像成为一种由需求去决定的东西的时候,你看,在这种情况下,我确实没有办法到现场,但是我又需要这样一张照片出现,在这种情况下就会变成什么?重要的就不再是摄影师本人在不在现场,甚至你也可以不关心这个事件到底应不应该发生,重要的变成了我得找到一张可以配得上现场的照片。帕尔默就讲说,这实际上是纪实摄影遭受到最大的考验的时刻,它可能完全被卷入到了一种基于需求的影像的逻辑当中,不再关心它的事实和原因,关心的更多的是它能带来什么效果。
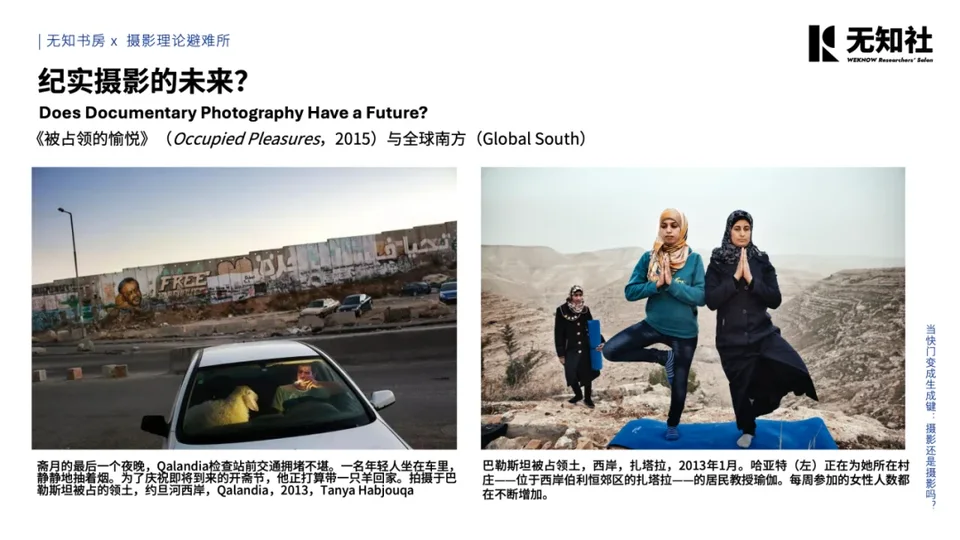
而这样一种方式,其实影响了我们对于整个全球南方的观察方式,不管是种族、阶级还是殖民主义,这些东西一直在影响着西方的主流媒体去呈现那些南方世界的方式。而往往他们所呈现的这些全球南方的景象,只不过就是把这些人反复不断地固定在难民、贫困的人、受害者这样的一些“理所应当”的符号当中去而已。而且这些摄影师就算到了巴勒斯坦,他们拍摄的内容也是这些在以色列占领下惶惶不可终日的这些人,因为这些摄影师基本上都来自全球北方,他们觉得巴勒斯坦人就应该天天生活在这种吃不饱、穿不暖的状态当中。所以他要拍这样的一些影像。这也就意味着说,不仅仅照片的内容是单一的,它所依赖的讲述的结构也是单向的。
然后帕尔默就讲,这样一种结构,因为它是从需求出发的,所以根本上就破坏了纪实摄影在贡献一个新的、或者说更新我们关于共有现实的机制的认识上的可能性。里钦认同帕尔默的看法,因为技术的进步并不等于观看的权利得到了重新分配,并不等于说:谁该定义我们如何去观看某一类特定的群体这样的一件事情发生了改变。单靠技术进步这个事情无法发生。真正重要的突破,往往并不是来自于新技术的出现,而是来自于决定影像生产的权力的分布的变化。
所以他特别提到一个摄影师,就是我现在给大家展示的作品,叫做《被占领的愉悦》。这个作品比较特殊的一点在于,作者没有把加沙描绘成我们熟悉的那种受苦受难的场景。它展现的像是一些日常生活当中的幽默、一些快乐。你比如说左边那一张,它是《光圈》里面放的照片,这人在自己的车里坐着抽烟,他旁边有一只羊,是因为要庆祝马上到来的开斋节,他要带一只羊回家。右边这个更典型,是当地的女性在做瑜伽的影。摄影师没有把加沙描绘成一种我们以为的无尽苦难的那种状态,作者在里面发现了很多具体的——可以说有的是微小的,有的是比较重大的——快乐、幸福。这样一种方式就拒绝了那种把加沙呈现为一个抽象的受害者空间的模式。
所以阿祖莱讲到巴勒斯坦受难者的影像的时候,就说,有人反对那些用某些视觉模式去套难民的影像的做法,比如说用一些圣母怜子图的图式,让巴勒斯坦所谓的难民在镜头前面摆圣母怜子的姿势,然后把它拍下来。有人指责这种做法可以说是对当地人民的一个霸凌。然而阿祖莱其实不同意这个观点,因为母亲同意摄影师以这样的方式拍摄自己和自己的孩子这个行为本身,这里面蕴含着的同意的效力是不能忽略的。某种意义上,他们是有以这样的方式被看到的需要。而且阿祖莱也这样说,巴勒斯坦人在照片里面表现出来的那种直视镜头,或者说像镜头回望的姿态,是代表着,这些人以这样的方式去宣告:我们不应该把他们永远固定在难民标签和身份里面去。
这也是里钦在讲到对谈后面讲到全球南方的时候,我觉得比较有意思的一个点。真正意义上的影像生态的民主,不是说让 AI 民主化、平等地模仿所有地方的影像,而是要让那些地方本身、那里的人自己能够成为这些影像的生产者,能够成为依靠这些影像发声的人。关键是,我们有没有这样一个机制,能够允许、或者说能够让全球南方自己决定如何呈现他们自己?如果这个结构不变的话,AI 做得再逼真,都是可以说是没有作用的。
7. CREATION MYTHS: Why we need a new image criteria
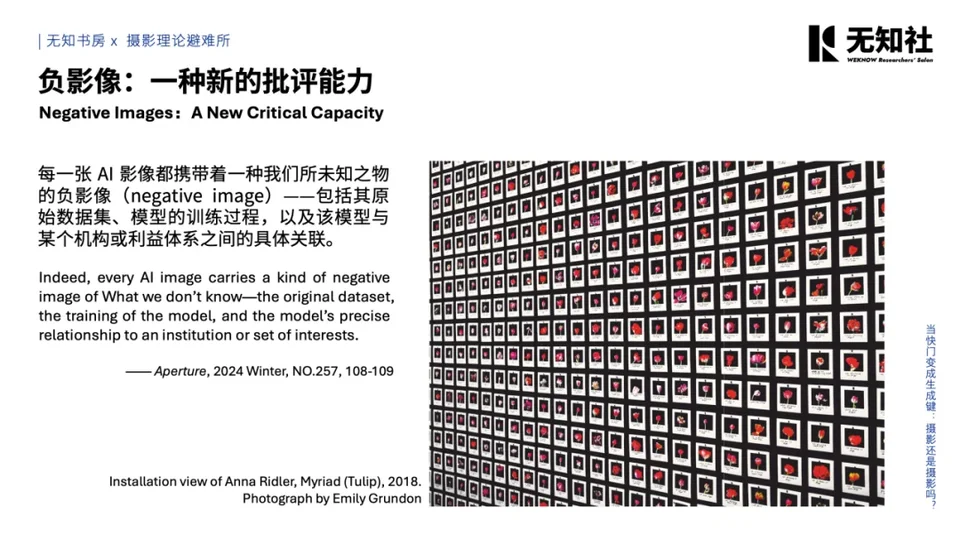
我要说的最后一篇是《创造神话》。这一篇提了一个关键词,就是“负影像”(negative images)。讲的是那些在被生成的 AI 影像背后所用到的那些不可见的东西。她的思路我觉得跟帕格伦是有点像的,帕格伦做“数据集考古学”,而诺拉·N·汗讲“负影像”。因为我们现在每天基本上所有人都能看到一些生成影像,但是你知道它不是照片,但是又像照片,你知道它是机器生成的,但我们不知道如何判断 AI 生成的影像的好坏。那在现在这个时代,很多影像可能都不是为了人类准备的,人类也看不到它们,但是算法和机器能够读取。在影像产生这样一个变化的时代,传统的艺术史批评的方法还能不能用?这是哈尔·福斯特(Hal Foster)之前讲过的一个问题。这篇文章的作者就找了另外一个思路。她认为,我们现在需要的是另外一种新的批评能力。新的批评能力不是去分析影像呈现出来的样子本身,而是去分析潜藏在影像下面的负空间里的东西的能力。
我们之所以对 AI 影像感到困惑,不是因为它太陌生了,而是因为它太熟悉了,它太像我们以前见过的那些东西。它熟悉到会不停地复制我们已经有的各种各样的审美套路。它看起来的那种新奇,其实只不过是很多已经有的东西的混合物。可是这背后一整套的训练数据究竟是如何被运用的?模型是怎么被训练的?数据是怎么被筛选的?有哪些面孔进入到了数据集里面?这些东西决定了 AI 如何看待这个世界、如何运用它的这种世界观来生成影像。所以她就讲,一张对 AI 影像恰当的观看,必须同时是在一个批评系统下对它的观看,不只是看它生成的结果,而是要问它到底是怎么生成的。所以她就讲了“负影像”的概念:每一张 AI 影像都存在一个我们看不见的、不能直接可见的“负影像”。包括其原始数据集、模型的训练过程,以及该模型与某个机构和利益体系之间的具体关联,这些东西其实构成了 AI 影像生成的那些负面——就是没有被光线照到的阴影的那一面,反转的那一面。
我觉得这是一个很好的视角。比如说一个扩散模型,它从几百万张 19 到 21 世纪的影像当中去学习“人”这个东西到底该长什么样子。你让 AI 生成一张人的影像,如果不告诉它是什么人的话,那这种人的影像人长什么样子?它到底依据什么标准来执行这个策略的?它应当以什么样子的人作为所谓人的形象的基准?又有哪些样子的人在,甚至是在影像生成的数据集标注的过程当中就被筛掉了?比如说可能有些面部畸形的人,是不可能在这种数据集和 AI 的关系里面出现的,但现实里又存在着很多这样的人。而对 AI 最后生成的标准肖像来说,没有这些人的位置。这其实是一个选择的结果。而所有这些被排除掉的东西,都是最后得到的那张影像的“负影像”。不能说只看最后的生成结果,不看它整个生成出来的过程。我们现在今天在看这种 AI 影像,不能只评价它像不像,你也不能只评价它是真的还是假的,而是说,我们现在必须慢慢地学习一种新的能力,新的批评能力,就是要去读出影像当中的“负影像”,要去意识到这些影像背后不可见的那些层面。也就是说,我们应该去追问,到底是谁训练出来的?为怎样的人服务?背后又依据什么样的价值观?而如果缺少对于“负影像”的意识的话,我们就很容易把 AI 的影像当成是一种中性的,甚至所谓的客观的一个东西。这是她在这一篇很短的文章里面提到的一个概念。
最后我跟大家再分享一段话,这也是里钦讲出来的,作为整个分享的一个结尾。他说:
我们已身处一个不同的时代。“相机不会说谎”这句话,如今即便作为神话也已难以成立。[……] 我们必须更清楚地向公众说明不同类型的影像间的区别,包括它们是如何被制作出来的、由谁制作的。我们需要一场广泛的行动,以帮助重建那种对现实的共有感,同时也要在此过程中大大丰富和深化我们对“真实”/“实在”(the real)这一概念的理解。
——The Simulated Camera: A Conversation with Brian Palmer, Fred Ritchen, in Aperture, 2024 Winter, NO.257, 101.
问答 Q&A
Qiu
谢谢 Prismo。刚刚在聊天框里有两个朋友提出了问题。
第一个问题:从符号的角度看的话,我们可否说摄影的那种相对直接的指涉其实是比较晚近的、独特的,反而是 AI 生成的模仿某种风格的影像,更符合符号长久以来的指涉性?
回答:我觉得其实不是这个样子。因为你是讨论 AI 影像跟传统的纪实摄影的影像的这种指示性,在思考题讨论哪一种更真实、或者更深层、或者更直接、更本真,单独去讨论这个问题是不成立的。因为任何指示性必须在一个解释的框架当中它才是有作用的。这个解释的框架就包括我们所说的,你在根据这张照片遭遇的时候所运用到的那些“附带知识”(collateral knowledge),就是在你读这张照片之前就已经知道的知识。所有的这些东西,包括照片本身附带的语境,它会形成一个解释的环境。只有在解释环境下去讨论符号的指称行为才是有意义的,不存在那种某一种指称的行为是更本质的,或者是更传统的、更本真的情况。而且一般意义上我觉得,在符号学的意义上,我单纯地去讲照片只具有“index”属性的话是不对的,因为任何的影像都可以有指示的属性,哪怕是绘画的也有的,它可以指向画家的手。画作可以指向画家的手,然后手又指向另外的别的东西。指示性一定要看你在什么条件下去解释它,这个是我的回答。
Qiu
好,谢谢。然后聊天框中的第二个问题是:请问摄影真的能跟图片所等同吗?摄影貌似是一种写真技术或者说是过程,但是图像可能是一种结果,或者说图像才有意义。
回答:我觉得肯定首先有一个区别是,摄影跟照片是不一样的。图片是一个更大的范畴,图片包含了你在杂志上看到的那些,比如绘画也算图片,但是它跟影像不一样,照片跟摄影也肯定是不一样的。因为现在很多论文在写的时候会混淆摄影和照片那个概念,把它们两个等同成是一样的东西,我觉得完全不一样。摄影是摄影,照片是照片,为什么?摄影是一种什么样的存在?你在开车的时候你碰到红灯,为什么你不敢一踩油门就冲过去?是因为你知道头顶上有一个监控摄像头。在这种情况下,当你时速飙到 120,碰到红灯你就踩一脚刹车的时候,你采取了行动,但是有没有照片出现?没有照片,因为你遵守了规定,没有触发拍照的事件出现。但在这种过程当中,摄影有没有发挥作用?有的,它是有发挥作用的。在这种情况下,你就不能说只有最后的照片或者影像才有意义,它的存在本身就会变成你生活当中无处不在的一个潜在的事件,它不局限于某一次单次的按快门的过程,我是这样理解的。所以在这个意义上,摄影跟照片绝对不能混为一谈。
江融
非常感谢国森,我觉得他花这么多的时间把《光圈》杂志上去年最后一期的文章给大家分享、总结出来,我觉得非常好。另外提出的这个问题本身就是非常有意义——“当快门变成生成键的时候,它是不是还是摄影?”
那么我听下来以后,我有这么几个想法跟大家一块分享一下。首先我注意到就是《光圈》杂志,它非常的“consistent”——英文叫 consistent,就是前后一致的,都是用“image”这个词。我相信国森知道我为什么一直要强调这个词的重要性,因为我注意到,因为我们的话语,我们的言说实际上是代表了我们的思想,包括我们的口误和我们的笔误,其实也代表了我们的思想。那么我发现就是国森,尽管他今天在演讲的过程中也一直都在用“影像”,但是中间还是有用“图像”,所以我还是要强调“图像”与“影像”之间的这种非常大的差别。“图像”它只能是画出来的,或者说是刚才就像国森说是从杂志报刊上面出现的那种插图叫做“图像”,但它原本是来自于绘画,而现在 AI 所生成的是“影像”。即使我们让 AI 生成这个软件来生成一幅特别像梵高的画,那么你要仔细去想的话,它仍然是一个像梵高画的“影像”,因为它的载体是一个影像,它不是绘画,但它也不能完全是摄影。是不是摄影我们可以来继续探讨。我个人觉得“摄影”这个词它实际上是一个特别大的容器,它有很大的一个 plausibility,它的可塑性是非常强的,包括从数码技术出现之后,包括现在 AI 生成软件出现之后,它是不是还是摄影,我们可以再讨论。但是我们一定要注意要前后一致地使用“影像”,而不是“图像”。其实这个问题在 1985 年弗鲁塞尔,他写到他的著作《迈向技术影像的宇宙》的时候已经解决了,他当时就提出来说,用电脑生成的影像应该叫做“技术影像”,而不是“图像”,所以我觉得这一点非常重要。
那么刚才包括我们在谈到帕格伦的时候,我们——或者说我们刚才所谈到的那些影像,说成是“摄影师”帕格伦生成的,其实这个也是有一定的问题。因为帕格伦他本身可能是曾经用相机,或他自己做的相机去拍摄过,但是我觉得他更多应该被界定为是一个“艺术家”(artist),而不是“photographer”,这是另外一个问题。
另外我上个周末问过肖尔,我说你会用 AI 来创作吗?肖尔说他不会,他说他更愿意到现实世界中去体验、去拍摄。那么我觉得肖尔是属于这种“straight photographer”,纯粹摄影的一个代表人物,他更多地会把自己界定为是一个摄影师或者艺术家。但是我们现在用 AI 软件来创作的这些艺术家应该是叫做“image maker”,造像师。但是我们当然也不会这么用,我们觉得我们把它叫做“艺术家”就更好。但是我们必须要分两类,就像里钦最后说的,我们必须要把这个影像的不同类别分清楚,纪实摄影和艺术摄影是两类的。所以我就会说,肖尔可能不会用 AI 去创作,但是杰夫·沃尔和古尔斯基可能是会用,其实古尔斯基早就用 Photoshop 来合成影像,所以我相信他们可能会用 AI 来创作影像,这是一个。
我觉得在我们现在“后真实”的时代,本身就充满了非常多的这种虚假的影像或虚假的信息的时代里边,其实我们更需要用相机去拍摄当下的所发生的所有的事件。因为这个当然既是摄影的一个范畴,或者是报道摄影的一个范畴。因为恰恰就是因为有这么多的虚假的影像,所以我们更需要有这种所谓的真实的影像,就是来自于现实生活中的这种影像。因为我觉得 AI 它最缺乏的一点,它可以模仿过去,它可以虚构未来,但它最难的一点就是“immediacy”——它最难做到的直接体验的这种东西,它没有,它做不了。所以它就会出现很多的这种马脚,你可以看出来它不是从现实世界中直接拍摄出来的,它没有“immediacy”。所以我觉得我们在言说的时候,我们的翻译——包括刚才用这个“Deepreals”翻成“深度现实”,其实我觉得应该翻成“深度真实”更准确,“现实”跟“真实”是不一样的。所以我觉得有很多的这种翻译要非常准确,我们在演说的时候要前后一致。
里钦提出的这一个词汇叫“photo-realistic image”。我觉得我跟国森也讨论过,我个人觉得目前还没有一个固定的准确的方法,但是大致的应该是翻成“像照片的影像”,它看起来就像照片,但其实不是,但仍然是影像。所以我今天说半天,我要强调就是“图像”和“影像”之间的区别,从现在开始恳求大家,当我们在谈论 AI 的时候,一定要用“影像”,不要用“图像”。好,谢谢大家。
回应:谢谢江融老师刚刚的补充,其实之前江融老师跟我讨论这个问题也过了很久了,他讲的其实就是“image”和“picture”,就是这两个词要分得很清楚。然后后来我在看文献的时候,我发现说,因为我们现在中国这边做翻译和对这个词的看法,很多时候是混着用的,觉得这个“image”,他们会判断说这个地方应该是“图片”“图像”,甚至还有“形象”,就是把它给分给了这个词,混在一起翻译。但实际上这样弄的话会带来很多混乱,我觉得也没有必要,因为影像——动态的东西也可以叫影像。就像帕格伦刚刚我展示的那个视频,就是《光圈》杂志也讲了这个作品,但是它不是一张照片,帕格伦的作品不是“图片”,它就是“影像”,就是一个会动的动态的这种影像。所以我觉得也很感谢江融老师的纠正,这个东西确实如果说我们能接受它的话,后面大家看这些文献其实反而会变得更清楚的,区分它们还真的是蛮有必要。
刚刚江融老师提到,现在这个环境下去拿起相机上街头或者去其他地方拍摄的行为,所以我也蛮有感触的。因为之前 AI 出现的时候,好多人就在问说,AI 都出现了,我们还有没有拍照片的必要,纪实摄影是不是就死掉了?我当时的态度其实不是这个样子。因为恰恰是因为 AI,我们这些真正拿起相机去上街头拍摄的价值才会凸显出来。因为你这样一比较的话会发现——去举一个不太恰当的例子,如果说你要结婚,你是想要 AI 给你生成一个看起来很完美的结婚照和现场婚礼的照片,还是想真的请那样一个摄影师——哪怕他拍的没有那么好——到现场把这些东西给你记录下来,对吧?我觉得可能很少有人会选前者。
而且评论区里也有人问说,AI 生成它的影像逻辑是“生成”,然后我们对纪实摄影的思考是“抓取”。我觉得“抓取”这个行为到刚刚又让我想到,之前有人问过肖尔一个问题,问肖尔说,你认不认为游戏截图算摄影?然后当时肖尔的回答说他觉得算,为什么?因为他说,对于他来讲,摄影就是对现存世界的“分析”,不是“composition”,不是组合,是分析,通过分析这个面前的世界来生产出照片的行为就是摄影,所以他当时的回答是肯定的。那么现在评论区有朋友说,摄影是“抓取”,我觉得这个“抓取”其实某种意义上也是一种分析,你是分析面前的世界,本身就是一个体验。而这个体验的过程和体验的价值,还是没有办法被你最后生成的照片所抵消的。就算 AI 生成的照片真的比你自己拍的好看,但是它没有办法给你一个说你真的上街头去分析世界的那样一个体验和经验,这个就是我最后做的一点补充。谢谢 Qiu,谢谢江融老师,谢谢大家。
Qiu
谢谢江老师和 Prismo。我们今天的分享就到这里了,非常感谢大家的参与。我们无知社每个月都会举办读书会和跨学科分享会,我们下个月的无知书房活动会在公众号的预告里,欢迎大家关注公众号和小红书平台。我们本次的活动视频会在无知社 B 站上进行回放。
主办:无知书房、摄影理论避难所
主持:Qiu
策划:王润玺、Qiu、Connie
分享:陈国森