Diffused Seeing: The Epistemological Challenge of Generative AI
关键词:熵 弗鲁塞尔 生成式人工智能 人类 非人类 知觉 Stable Diffusion 理解
认识论框架
本文旨在探讨被称为“生成式人工智能”的机器学习技术,是如何改变人类与机器之间关于“观看”与“理解”的关系的。论述的起点奠基于这一假设之上:现代知觉及其所包含的多种观看模式[74]——无论是在人类还是机器那里——根本上都是摄影性的,这种摄影性并不等于纯粹的视觉性[72]。自十九世纪初摄影媒介发明以来,随着摄影在不同阶段的发展(从模拟到数字,再从网络化到生成式),知觉本身也在不断被扩展。过去六十余年间,各类计算机器、传输网络和触觉传感器的组合,逐渐对视觉感知装置进行了增补(supplemented),使之涵盖了其他的感官体验和数据。本文聚焦于这一摄影发展进程中的最新阶段:由机器学习驱动的模型(即所谓“生成式人工智能”)所创造的摄影写实主义影像(photorealistic images)。以 Stability AI 公司的 Stable Diffusion 为个案,本文将视线聚焦于这些生成式模型的摄影性基础,即其训练数据主要由照片组成这一事实;与此同时,其输出结果旨在与源素材保持同样的摄影式逼真度(verisimilitude),尽管这种逼真度经由多种风格的再媒介化(remediated)后,往往超出了直接写实主义的范畴。
本文的论证将通过分析一个支撑当前许多文生图模型(不仅是 Stable Diffusion,还包括 DALL·E 2, Midjourney, Imagen 和 Firefly)生成过程的哲学与技术概念——“扩散”——来展开。本文主张,将“扩散”纳入其技术与话语配置中的文生图模型,其摄影性的框架,针对我们当前关于再现(representation)的观念、以及我们(人类)观看和理解世界的方式,提出了一系列根基性的问题。然而,我们必须从一开始就承认,“扩散”只是影像生成模型的异质架构中的一部分,这些架构还包括变换器(transformers)和生成对抗网络(GANs)[75],甚至有些模型(如谷歌的 Parti)的架构中并不包含扩散机制。但就本文目的而言,许多生成模型都将“扩散”作为一种技术和修辞手段纳入其中,这表明了一种更广泛的倾向:不管是在这些模型的技术基础设施中,还是在我们更广泛的数据与影像生态中,一种关于建构可渗透性与不稳定性的趋势,正在逐渐形成。由此,本文将探讨以下问题:当我们的世界知觉以及由此确定的认识论,经由那些建立建立在非稳定设计架构(包括噪声、模糊、扩散与数据压缩)之上的生成模型的中介之后,是否已经发生了改变?这种知觉和认识论,在社会层面上是否已经彻底地失稳,以至于有些人甚至将生成式人工智能的发展等同于了虚无主义甚至法西斯主义?又或者,这种发展是否能以一种弗鲁塞尔式的态度去看待,即认为它们开启了某种解放的可能性?尽管本文采用的是批判后人类主义[89]的视角,但仍会以“我们”这个基于特定物种的概念——即技术构成的人类——作为论证的锚点,同时也关注这个脆弱的物种单位内部的生命政治与地缘政治权力差异。文章将沿着理论路径展开,但影像也将在其中发挥重要作用,它们不仅是分析的对象,更是作为一种具现性的(enactive)①“思维设施”(thought devices),其作用超越了单纯的插图。
摄影性知觉
关于摄影在构建我们的世界图像(picture of the world)乃至世界本身这一过程中所扮演的角色,学界已有诸多论述。20 世纪 20 年代和 30 年代的欧洲先锋派思想家和创作者们,已通过一系列政治姿态拥抱了摄影激进的创造力。对于奥西普·布里克(Ossip Brik)、亚历山大·罗琴科(Aleksandr Rodchenko)或拉兹洛·莫霍利-纳吉(László Moholy-Nagy)而言,对摄影媒介的后画意主义(post-pictorialist)用法,不仅成为了一种重新观看世界的方式,更成为了为世界具现一种“新视觉(New Vision)”的手段。莫霍利-纳吉宣称摄影能够“(在光学上)为世界带来崭新事物”[66],从而将形式实验与社会进步思想联结在一起。莉兹·威尔斯(Liz Wells)在追溯 20 世纪早期至中期的“摄影式观看”的历史时指出:在欧洲,对摄影媒介的美学实验是与实施社会变革的愿望相关联的;而在北美,它更侧重于个人表达与自我反思,而变革主要是在个体层面具现的[90]。随后几十年里,大西洋两岸那些具有社会参与意识的作家们,继承了这种对摄影式观看所具有的具现力量的信念。对于约翰·伯格(John Berger)而言,一张照片始终体现着“一种观看方式”[11]。苏珊·桑塔格(Susan Sontag)在她 1973 年出版的经典著作《论摄影》中声称,“照片改变并扩展了我们关于什么值得看、以及什么有被看到的权利的观念”[57];她甚至提出“我们对情境的感知本身”就是由照相机的操作所具现和证实的。桑塔格认为,“最终,拥有某种体验,变得与拍摄一张关于它的照片等同,而参与公共事件也越来越相当于以被拍摄的形式观看它”[91]。这番言论,听起来仿佛预言了二十一世纪初的社交媒体影像泛滥时代。伯格本人在《摄影的用途》一文中回应了桑塔格的论点,他以《生活》杂志刊登的照片为例指出,它们不仅仅是关于(about)生活的。他带着些许绝望宣称:“这些图像就是(are)生活,”[13]。伯格为之感到忧虑不安的是:在工业资本主义背景下,生产出这些影像的相机,采用了一种全景式的、超然的上帝视角,由此抹除了社会语境——人的苦难、阶级不公、剥削——从而使得影像脱离了历史、记忆和所有的真实痕迹,并在它们之外自由浮动。在一段犀利的诊断中,伯格预示的似乎不仅仅是社会摄影时代,还有生成式摄影时代;他哀叹道:鉴于照片本身不承载任何意义,它们“可被用于任何目的”[92]。
伯格在 70 年代末特别关注的照片用途包括广告和宣传,但他同样忧心于去语境化的影像的无尽洪流。战争和苦难照片脱离了图说和叙事,自由传播,最终导致观者的知觉体验变得麻木。为了将这种盲目的视觉消费引导到一种可被称为伦理观看的方向上,照片需要多重的框架(或如伯格所谓的“辐射系统”)[109],这些框架由历史、政治、美学和经济等多个维度构成。尽管伯格这种以人类为中心的人文主义关怀,在生成式人工智能时代可能显得过于理想化和陈旧——在这个时代,所有影像都以一种分离的、去语境化的、可替代的、无框的和短暂的形式呈现给我们——但他的分析背后强烈的伦理—政治律令并未失去其紧迫性,其力量和要求,甚至超越了当今关于 AI 监管或 AI 伦理的疲弱的呼吁。米特拉·阿扎尔(Mitra Azar)、杰夫·考克斯(Geoff Cox)和莱昂纳多·恩佩特(Leonardo Impett)作为《人工智能与社会》(AI and Society)关于“机器观看方式”特刊的编辑,已经认识到了这种紧迫性。该特刊的目标是调查在机器视觉和算法学习的时代,当某些博弈的主体可能是完全意义上的非人类时,伯格关于“看”与“知”之间的关系所涉及的持续博弈过程的设想,在多大程度上仍然成立。阿扎尔等人提出,在当前的形势下,“一种新的知觉模式正在逐渐落地……:一种新的(机器)观看方式,它是其各个部分的集合体;包括成像设备(如相机)、它们产生的数据(可能是以影像的形式)以及它们赖以运作的、更广泛的实践和基础设施”[93]。知觉仍然需要一种持续的对话,但这或许必须得需要通过人类与(and)机器的语言来完成。
生成模型利用摄影影像和美学来模仿源素材;至于由此产出的影像输出具有何种本体论地位,我们暂且搁置不谈。本文的核心观点是:这种新的知觉模式仍然是摄影性的。事实上,目前支撑生成模型的大部分训练数据都是由数十亿张照片组成的[20][41]。[76]照片之所以被如此广泛地作为训练机器学习模型的主要来源,不仅是因为它们可以通过社交媒体平台、网站和档案库(从 Pinterest 到 Wikimedia Commons 等)直接获取(尽管在隐私和产权方面存在问题);更重要的是,这还与许多计算机科学家对摄影影像所抱持的基本假设相关。这一点,在 ImageNet(用于开发计算机视觉的早期大型数据集之一)首席研究员李飞飞关于其构建过程的叙述中得到了证明。ImageNet 于 2009 年推出,最初只是一个包含一万张不同对象标注影像的小型数据集,分为 20 个类别。只有当这个数据集将其规模扩大到 1400 万张照片时,它才真正打出了名头 —— 通过爬取互联网平台上大量的“免费”照片,并且在亚马逊的 Mechanical Turk 在线市场上利用廉价劳动力对其进行标注,Imagenet 扩展到了这个规模。“最近,李飞飞在庆祝数据集十周年的活动中被问及为何 ImageNet 选择使用照片来构建,她回答说:‘这是个好问题。我们当时并没有真正停下来仔细思考过 [……]。我想我们要的是对世界做尽可能逼近的再现[94]’”[21]。在这类叙述中,照片只是“在那里”,供研究人员和科技行业随意获取、采集、编目、标记并按其意愿使用,这引发了巨大的道德和法律问题。更重要的是,照片在计算机科学研究中被假定为通向世界的窗口,提供了关于“外部事物”直接且真实的影像。它们被认为能够直接呈现和再现多个具体对象与行动,而这些对象与行动不仅能被置入离散的框架之中,还能经由标注,被确立为超越时空限制的半永恒形式的代表。
因此我们可以得出结论,这个致力于完善图灵机(一种可广泛适用的差分计算系统)的产业,其概念上的基础居然依赖于一种简单得多的技术。借用雅奈·托斯特(Yanai Toister)的话,这种技术可以被称为“都灵裹尸布模型”(这个名称指涉的是一件据称包裹过耶稣尸体,并印有其轮廓的天主教圣物)。在这个模型中,照片被“视为某种享有特权的,甚至是奇迹般的转移案例”[59]。计算机科学家们似乎并未受到关于摄影媒介指示性(indexicality)之局限的争论的影响,而这一争论困扰了摄影理论家们数十年之久。在机器学习的数据集中,摄影拥有一种“本体论特权”[59],外部对象据此在影像中显现,从而“在观看照片和观看世界之间建立了一种假定的一致性”[95]。这种信念不仅适用于所谓的一级照片(出于社会、纪实或艺术原因拍摄的人类、动物、风景和无生命物体的影像),也适用于对艺术品(绘画、雕塑)的摄影记录或对平面物体(图形、地图、文本)的扫描。这里没有伯格那种设想的容身之地,即要通过记忆、历史、经济和美学维度去构建照片的多重框架;训练数据集中的影像就是“物自体”的流溢;它是通向对象识别的直接路径,也是其条件。
重要的是,供给机器学习数据库的,(绝大多数)不仅是摄影影像,而是影像—文本对,这使得计算机能够通过其名称(即标签)来识别对象。多年以来,用于收集并标注机器视觉应用所需影像的网络采集技术,已经随着时间推移发生了变化。虽然在 ImageNet 中,负责标记影像的是匿名的人类劳工,但支撑 Stable Diffusion 的公共数据集 LAION-5B(包含 58.5 亿个带图注的影像)则使用了一种名为 Common Crawl 的自动化程序,它从 Pinterest、WordPress、Blogspot、Flickr、DeviantArt 和 Wikimedia Commons 等各种网站爬取影像—文本对。这些影像是由网民们在许多年间上传、标注的,其中集体的、无偿的身心劳动,连同其知识、无知、偏见与成见,悉数反映在了该数据集中。计算机科学家当然知道数据并不完美:在当今许多计算机科学论文中,提及(尽管并未解决)偏见问题以及版权问题似乎成了必要之举。其中占主导地位的假设是:数据集会随着时间的推移而改善,数据的进一步积累将平均掉所有潜在的问题,使我们更接近客观性和真理。在机器视觉的主流应用中,始终如一的,是对影像及其指称(signification)的一种常识性实证主义态度,或者说是对影像与其指称对象之间的再现鸿沟的抹除。艾伦·塞库拉(Allan Sekula)在 1975 年就已经洞察到了这种倾向,他不无讽刺地指出,“没有什么比……一个人从钱包里掏出一张快照说‘这是我的狗’更自然的了”[54]。在今天的计算机科学中,那人名叫“群(legion)”②,他们的狗可能是一只猫——而且这种展示是大规模进行的,不仅展示给人类之眼看,也展示给机器之眼看。
对机器视觉而言,知觉的结构逻辑以此为前提:距离的消除,前景与背景区分的瓦解,以及形式的扁平化;由此,世界中的三维物体被再现,或者更确切地说,是通过选择它们的“特征”(即机器视觉系统可读的元素)被渲染为二维模型。一种耐人寻味的切割与分划过程在图像的框架内展开:系统通过在影像中不断划分出多个识别区域的方式,来将照片拆解成若干被视为独立对象的单元。因此,照片被“扁平化为一组可标注的对象”,而不再被视为“一个具有关系意义的连贯整体或有机组合”[61]。阿曼达·瓦西莱夫斯基(Amanda Wasielewski)解释说,由于机器视觉算法致力于创建能够识别对象的通用模型,所以用于训练数据库的照片只需“刚好够用”即可。[77] 影像在数据量上的缩减与其符号学层面上的扁平化相结合,或者用尼古拉斯·马勒韦(Nicholas Malevé)和卡特里娜·斯鲁伊斯(Katrina Sluis)的话说,这就是从再现性(通过摄影技术对对象的中介)向代表性(即提供一组据称有代表性的摄影影像样本)的转向。他们将这一操作解释为“一种障眼法”,使计算机科学研究人员能够“避开每张影像的文化语境,从而优先考虑统计分布的问题”[41]。概括化(generalisation)与平均化原则相结合:这个房子的影像需要在某种构成层面上类似于其他房子的图像,以便将其“房子性”(houseness)提取为一系列数据点,这些数据点所对应的,正是那些机器认为构成了该对象之关键特征的元素。
总而言之,随着机器视觉的出现,这种摄影式的世界知觉已经发生了改变:不仅在于影像的观看者不再是人类[48],更在于摄影影像本身可以被描述为非人类的[68],它受制于大量涉及碎片化、提取、缩减和消除的数据操作,这些操作超越了人类的意向性和能动性。人类仍然部分地介入着这些操作,尤其是在将对象简化为影像、将丰富的影像数据缩减为可提取和可交换的特征序列的基础决策中。[78] 生成式人工智能采用了“刚好够用的”中庸原则③,并将这些影像从再现转化为图式、继而转化为模型。正是在这一转化过程中,蕴含着生成式 AI 的独特性:它构成了“摄影式观看”的一种特定的迭代形态。在 Stable Diffusion 中,正是在所谓“潜空间(latent space)”中对影像进行的编解码,推动了该模型的成功——潜空间是一个简化的数学空间,影像在此处可以被缩减尺寸(或者更确切地说是通过更少量的数据来再现),以便快速进行多重操作。
摄影式观看模式向机器视觉的扩展,意味着一次重大的认识论转变,这一转变影响并重塑了我们惯常的、人文主义式的“理解影像”的观念:既我们理解影像的方式究竟如何——既作为照片,也作为关于我们自我之表象。此前已有一些有力论证指出[96],传统的摄影理论——无论其关注照片意义[6]还是其用途[12]——难以充分解释网络计算环境给摄影影像带来的转变。然而,更为重要的是,先前所说的这种扩展,对我们关于“理解”的设想本身,也带来了深重的冲击。生成式人工智能模型所产出的那些逼真的、半逼真和超逼真的输出结果,对哲学家、媒体理论家、科学家和公众也提出了迫切的要求:它要求我们重新审视“理解世界意味着什么”这一设想本身——以及究竟是谁,或者是什么,有能力实现(executing)这种理解。
非人类的理解
机器学习中的“理解”,能否在生成式影像模型或大型语言模型中体现出来?围绕这一问题的争论,使学界分裂成了两大阵营。根据圣塔菲研究所(Santa Fe Institute)的计算机科学研究员梅勒妮·米切尔(Melanie Mitchell)和大卫·C·克拉考尔(David C. Krakauer)的一篇综述,在 2022 年的一项调查中,51% 的受访研究人员同意此类模型“在某种具有实质内涵(nontrivial)的意义上能理解自然语言”,而 49% 的人不赞成此论[43]。那些属于赞同阵营的人,通常采用的是功能主义的进路,即主张:如果一个模型的行为对外部观察者而言看起来像是呈现出了理解的样态,那么它就应该被视为具备理解。对于反对者而言,此类模型至多只能模拟理解:它们本质上就是埃米莉·本德(Emily Bender)及其同事所描述那种的“随机鹦鹉(stochastic parrots)”[9],只不过是通过大规模尺度上复杂的统计相关性,来模仿了类人的理解。AI 软件工程师及其背后的金主,往往会站在功能主义这边。这种(有时可能是带表演性意味的)立场,导致他们中的许多人既做出夸大其词的承诺,又做出含蓄的警告,声称 AI 在许多层面上都即将超越人类。这也使他们得以将自己同时定位为弗兰肯斯坦博士和人类的救世主。反过来,人文学者对“AI 在可预见的未来(甚至永远)达到人类理解水平”这种说辞,往往持批评态度。[79] 对哲学家约翰·塞尔(John Searle)而言,“这一思想实验凸显了这样一个事实,即计算机仅仅在用句法规则来操作符号串,但却不理解任何意义或语义”[23]。换言之,计算机执行的是一种“对意义的计算”[17]。梅赛德斯·邦兹(Mercedes Bunz)甚至断言,当今的 AI 系统仅仅是“通过计算意义来模仿对意义的理解,但它们并不真正理解——它们缺乏将其分类结果以一种整合的方式链接到一个更广泛的、不断变化的语境中的能力”[18]。
瓦西莱夫斯基(Wasielewski)关于文生图模型中“理解”问题的论点,与这一后塞尔式的立场高度一致。她写道:“DALL·E 及其同类,能够复制视觉形式,但无法‘意识到’或‘熟悉’它们所生成的影像中的指涉对象,也就是说,它们对输出影像中所描绘的物理对象、人或地点没有任何经验”[64]。反过来,人类观看者“对这些对象拥有充分的感官体验和随之而生的语境理解,这远远超过了从这一张数字影像(甚至成千上万张数字影像)中所能学到的信息”[97]。
在接下来一段值得长篇引用的文字中,瓦西莱夫斯基继续论述道:
文生图模型非常擅长识别作为单词输入的某物之影像。然而,这并不意味着它 (即模型)理解该影像实际上是什么、或它再现了什么。…… [它们]非常擅长从被标记为“狗”的像素模式和被标记为“海滩”的像素模式中进行外推,并生成出一张海滩上的狗的影像。模型仅仅是在学习一张被标记为“狗”的二维影像中的各种事物,以及一张被标记为“海滩”的影像中的各种事物。除了这些被标注出来、用于构造基于影像的再现的二维视觉模式之外,它并不理解这两个概念中的任何一个。换言之,影像生成器对现实世界中各种形式的理解极为有限,因为它们所处理的,只是数字影像而已。[98]
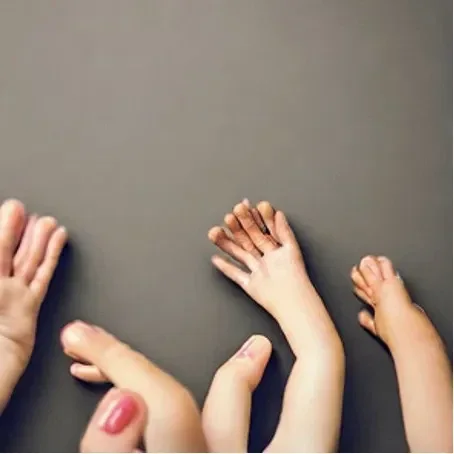
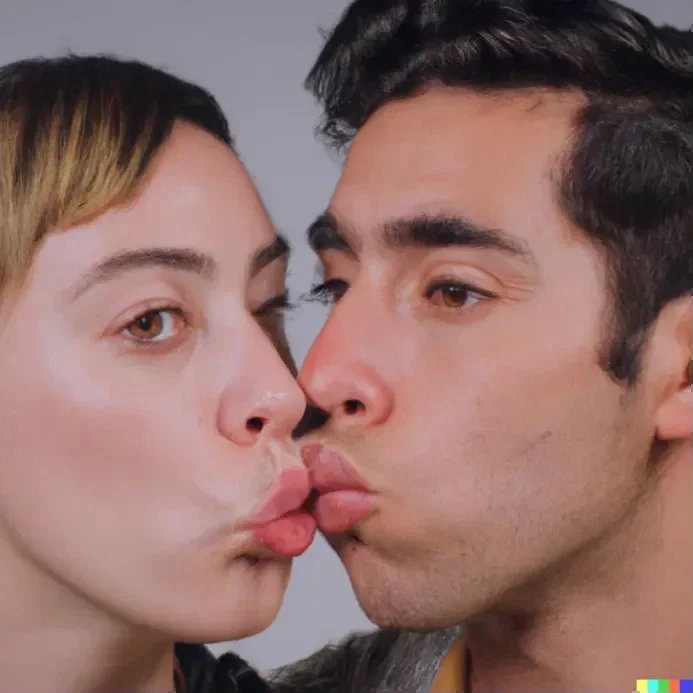
为了说明这种理解之缺乏的情况,瓦西莱夫斯基举了个例子:Midjourney 即使在提示词明确要求的情况下,也无法准确绘制“规范的”人类手部(图 1)。她在 DALL·E 和 Stable Diffusion 那也发现了同样的问题:所有 AI 影像生成模型都倾向于以“荒诞不经的方式”描绘人体部位[99]。在她看来,这表明,这些模型在“创造意义”[100]方面存在更深层的困难,只能退而求其次,依赖其自身的计算——这种情况导致了用户会产生些类似迷因一般的反应,诸如“Mj [Midjourney] 不会数数”[97]等等。艺术家、教育家埃里克·萨尔瓦乔(Eryk Salvaggio)在强调 DALL·E 无法生成可信的人类接吻影像时,也表达了类似观点(图 2)。他说,“有关接吻这个动作的影像所呈现出的‘强’模式是:它们都被犹疑所包围,仿佛影像中两个‘伴侣’间存在着某种无形的屏障。两个人物的嘴唇形态彼此是不一致的,因此始终无法真正地与彼此相吻”[51]。虽然瓦西莱夫斯基和萨尔瓦乔都未诉诸身体或行为的本质主义——他们实际上不遗余力地挑战围绕肉身性、健康、性取向和性别的规定性假设与健全中心主义(ableist)假设——但他们各自的分析,仍然是在某种关于“正确性”的理念之上展开其批评的。对科技公司而言,这些学者在 2022 年底和 2023 年初指出的问题,无疑将被视为纯粹的技术瑕疵,可通过更多的数据来解决。最终,随着像素统计分布的改善,“手”和“吻”的异常值(即偏离了预设的正确性标准的影像)很可能被消除。然而,这种关于人类身体“应该如何呈现、应该做什么”的、发生在特定时期中的讨论,恰恰触及了本文所关切的更深层次的问题:我们究竟应当依据什么条件和标准,才能在不落入表征论(representationism)陷阱的情况下,对以摄影式知觉来把握世界的 AI 模型提出质疑?
在“另类事实(alternative facts)”的时代,当摄影影像可以被用于任何目的,同时深度伪造(deepfakes)已嵌入营销和宣传之中时,再现的准确性问题,无疑应被严肃和审慎地对待。然而,本文的观点是,围绕生成模型运作方式(modus operandi)所提出的那种“还不够好”的论点,本身是不充分的,因为它最终缩小了我们用以介入、检验——以及质疑——生成式 AI 的概念范围。那种“它们并不知道自己在做什么”的批评模式,以否认 AI 拥有任何形式的意向性(哪怕是极其微弱的意向性)为前提,结果却重新引入了一套实证主义式的假设:关于世界的假设、关于观看世界之方式的假设,以及关于影像生成过程的假设;更不用说同时也默认了一种关于人的假设了 —— 即把人理解为自足而透明的主体,并且其意图和欲望总是可以被清晰地理解、清晰地描绘。因此,在不放弃对生成模型这一概念和技术局限性进行批判分析、也不吵嚷着把 AI 视为具有完全的意向性的主体的前提下,或许值得一问的是:这些“错误”的影像,能否被人类和机器以不同的方式感知和阅读?从风格上讲,这些“荒诞不经”和“犹疑”的渲染结果,与早期先锋派的视觉性之间存在着某种亲缘关系:超现实主义的梦幻美学,拼贴和摄影蒙太奇所体现出的技术主义外表。它们使人想到埃蒂安-朱尔·马雷(Etienne-Jules Marey)通过连续或多重曝光在胶片上记录下的运动中的身体、摄影记录下的皮娜·鲍什(Pina Bausch)的舞蹈表演,以及斯泰拉克(Stelarc)在《第三只手》(The Third Hand)表演中的影像。
因此,只有在我们预设生成式人工智能的首要功能是生产似真性,即创造更多我们早已拥有的东西时,指责生成模型“把事情搞错了”才是有意义的。然而,如果我们不再把这项技术视为以“对由自然语言界定的提示词给出准确回应”为前提的,而是将其视为一种对话性的东西(conversation pieces),一种挑衅(provocations)——或者如其名称所示,确实就是一种提示词(prompts)——那么情况将会如何?在这种理解之下,这项技术所开启的,将是一场与我们、并且为了我们而展开的对话:一场关于词语与影像之间、世界与其表征之间之根本不可通约性的对话。可能会有人反驳说,要阐明这一点其实并不需要 AI:从亚里士多德的模仿论到后结构主义,人文学科一系列的奠基性文献已经把这点讲得很清楚了。然而,批判性的人文教育越来越被指责为既不科学、又缺乏生产力,而 STEM 学科又被授予了知识王冠;在这样的情形下,我们难道不能尝试通过提出一些关于意义与理解之生成的根本问题,来偏转各类人工智能——包括“人类”这种智能——发展的那条不可避免的轨迹吗?当然,人类智能本身也是一种人造物(artifice),因为它是创造性(即创生的 [poietic])过程的产物,是一个随时间推移产生某种东西的过程。它由一整套后天获得的特征组成,这些特征使我们能够学习新事物、理解概念并适应环境,同时它本身也是在与该环境的关系中涌现的。(如果该过程的时间尺度足够漫长,我们就称之为“进化”,而其较短的阶段则被命名为“文化”。)
正如我们所见,围绕生成式人工智能中“再现”问题的讨论,将一个更高阶的元问题带到我们面前:即如何理解“理解”本身,以及如何感知据称构成了这种理解之基础的影像与模型。米切尔和克拉考尔指出,尽管“类人理解”缺乏严格的定义,但是在认知科学中,它通常被理解为一种创造与运用概念的能力,即形成“关于外部类别、情境与事件,以及一个人自身内部的状态与‘自我’的心理模型”[101]。这种能力允许人类进行预测、概括和类比;能够推理,并且同样重要的是,能够向他人解释自己的理解。许多人文学者主张,机器无法创造概念,或者至少无法创造出对人类而言看似有意义的概念[17][9]。然而,若我们提出,机器或许正在创造某种东西:或许它们正在通过某种对它们自身而言“有意义”的方式,来解析数据 —— 这样讲是不是太荒谬了?不过,若果真如此,那么我们是否也可以推断,某些由此生成的模式,对人类而言是不可见、不可解的,但对其他机器来说却并非如此?当人文学者们承认机器正在生产这样的“某种东西”——一种(心理的)图像、一个概念——的时候,他们可能会按塞尔和本德的立场,将之斥为一种仅仅“看起来像”有意义的影像或概念的东西。但如果那里的确存在着某种东西—— 某些我们人类无法看见的其他的模式与图像,其他的关联方式、模型、逻辑与连接形式 —— 正在涌现呢?那又当如何?米切尔与克拉考尔进一步追问:即便我们能够接受这些系统并未生产出我们所理解和认可的那种概念——亦即作为因果性心理模型的概念——那它们庞大的统计相关性系统,是否仍然能够产生在功能上等同于人类理解的能力?或者,是不是甚至可能带来某些人类无法触及的高阶逻辑形式?而在这一节点上,我们是不是仍然能够将这些相关性称为“虚假的相关性”,或者将由此产生的解决方案称为“捷径”?我们是不是仍能够将系统的行为视为一种“有能力而无理解”的东西?是否应该将之视为一种新的、非人类形式的理解形式?[101]
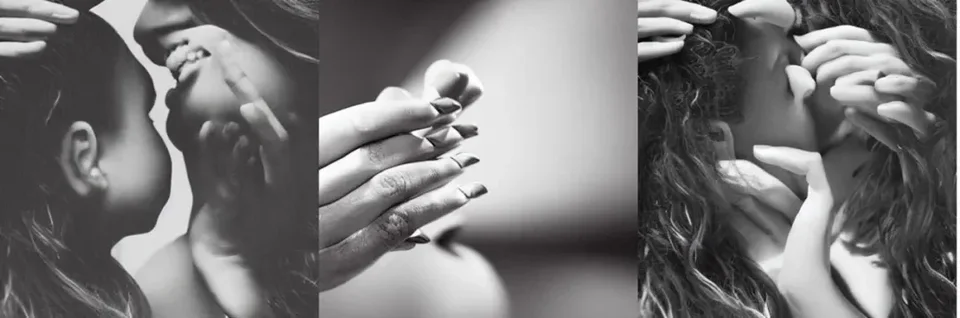
提出关于非人类的理解模式的问题,并不意味着要为科技公司开脱,从而允许它们借助其产品所谓的伟大之处——即便这种伟大仍充满不确定——而逃避对偏见、歧视、排斥以及对人类和自然资源的剥削掠夺等问题的责任。但这确实意味着,我们需要将生成式人工智能视为一种能够为我们创造可能性的存在,这也使得我们能够从自身那种过于人类化(all-too-human) 的,充满偏见、排斥与不公的存在模式、行动模式中,“去—观看”(unsee) 和“去—思考”(unthink)。仅举一例:当一个 AI 模型让我们开始思考“一个好的吻”可能包含什么、看起来像什么时,带来了什么后果?它是不是可以被动员起来,让我们重新想象那些超越了限制性极强的、过度约束我们的异性恋规范与人文主义的假设?(图 3) 当然,艺术家、电影制作人和 LGBTQ+ 社群(从莱奥斯·卡拉克斯 [Leos Carax] 的《神圣车行》[Holy Motors] 到郑淑丽 [Shu Lea Cheang] 的《菌丝网络社会》[Mycelium Network Society]),早就已经在重新设想这些问题的可能。然而,正如我们人类所称之为“文化”和“自然”的规范,从来只是暂时显出其稳定的形态那样[30][26],像 Stable Diffusion 之类的模型也揭示出:围绕我们的身体与生命所建立的视觉与文化共识,本身是建立在多么不稳靠的基础之上的。至少在一段时期内,它让我们看到了那些接缝处——尽管有人坚持称之为故障。
需要再次强调一下,关于意向性和目的性的讨论,在生成式人工智能的语境中是不可回避的,而且这种思考必须是持续的,并且必须同时指向人类与机器。法官在进食休息后做出的判决比平时更宽松,是由于其血糖水平变化所致,而不是出于对司法权复杂的理解[25];溺水者之所以能够获救,主要也是由于旁观者的身体反应冲动,而不是因为对道德与价值的理性权衡[80]。这两个例子只是人类意图与身体反应、冲动和驱动力相纠缠的例证的冰山一角。马克·阿梅里卡(Mark Amerika)在他与 AI 合著的那部颇具雄心的著作《我作为人工智能创意体的一生》(My Life as an Artificial Creative Intelligence)中指出:“艺术家与运动员凭直觉知道,他们必须要在甚至还没来得及思考时就完成下一个动作”[3]。[81]因此,仅仅以缺乏意向性为由就否定生成式人工智能,实际上忽视了这样一个事实:人类活动的大部分——包括人类活动中被公认为“艺术”的那种“生成性”变体——本身亦是部分地悬置了艺术家的显性意向与清晰意识时才能发生的。从安德烈·布勒东(André Breton)的纯粹心理自动主义,到让-米歇尔·巴斯奎特(Jean-Michel Basquiat)强烈的创造性幻视,无数绘画、素描、诗歌与装置艺术,都是在艺术家经由冥想、狂躁、摄入其他物质、或进入与其他能动者共创的过程中,经历了意识与能动性改变的状态中完成的。那些与机器合作的艺术家们——从机器人到神经网络和生成式人工智能——只是将这一创造过程中一直存在着的分布式能动性进一步凸显出来了而已[70]。那些生成式人工智能模型被人们认为缺乏真正的“理解”能力,这件事却反而能够提醒我们:人类并不总是完全理解或者完全掌握了自己在做的事情,以及为何如此。
因此,理解与非理解之间的关系,不能被处理为一个落在清晰的二元对立两端的理论问题,尤其是因为,其评判者——即人类自己——同时也是其立法者和执行者。任何关于“理解”的讨论,包括对“理解之理解”的元理解,都必须经由人类主体的身体装置来展开,而我们人类主体的构成本身早就已经是技术性的了。由此,我们得出了如下命题:生成式人工智能向我们显现并且构造出了一个关于“理解”的问题,同时也向我们提供了一种不同的理解概念。或许可以说,生成式人工智能产生了一种可称之为“不稳定的”(unstable)或“摇摆不定的”(wobbly) 理解,以及一种与之相关的“不稳固”(shaky)的知觉形态。我们下一节将要讨论的“扩散”,就可以被视作这一模型的成像模板。
不-稳定的扩散(Un-Stable Diffusion)[82]
本文第一部分所讨论的、支撑机器视觉的摄影式知觉模型,其自身就是经由一组颇能说明问题的术语与概念而被框定的。在进一步探讨当前的机器学习项目(如 Stability AI 的 Stable Diffusion)中那种既要稳定知觉、也要稳定对知觉之感知的欲望之前,值得先回顾一下机器视觉的若干历史先例,及其在修辞层面与动觉(kinaesthetic)层面的支撑。这是因为,这类技术发明的时刻可以充当我们人类重估自身的关键节点。在这些时刻,我们得以评估那些发明背后的假说与预设,从而在其技术的余晖中重新审视我们自己。
名字颇为古怪的“机器人 Shakey”(Shakey the robot,意为“摇晃者”)是早期机器视觉与计算机视觉设备中试图吸引更广泛公众的一员。它由斯坦福研究所(Stanford Research Institute)于 1970 年研发,借助安装在其身上的电视摄像机所接收的静态图片来收集周遭环境的信息。詹姆斯·E·多布森(James E. Dobson)在其著作《计算机视觉的诞生》(The Birth of Computer Vision)中解释道,这个名字可谓名副其实:
出于若干原因,Shakey 是一个不稳定的项目。这台设备……以一种一颠一颤的方式在空间中移动。这并非因为规划上的延迟(尽管延迟也加剧了设备的不稳定),而是缘于 1960 年代机器人学的整体状况。Shakey 最初通过无线电发射器,与一台大型的、无法移动的 SDS 940 通用数字计算机松散地连接在一起,而后者必须被安置在机器人物理位置的近旁。……项目本身也是以一种杂乱无章的方式朝着计算机视觉的开发推进的,其成果往往远不如项目立项书中所承诺的那样令人印象深刻。Shakey 机器人及整个项目的设计初衷,是为了满足 DARPA 对“能够在敌对环境中收集、处理和传输信息的自动机”的需求。[29]
多布森承认,这台机器人对机器视觉领域研究方向的转变作出了重要贡献:从依赖二维影像,转向成为“一种情境化的感知设备”[102]。但他也不无讽刺地指出,这个名字(最初指的是整个项目,而不仅是机器人)反映出:对于能否开发出一个在真实世界中运作的系统,工程师们自己的信念本就是摇摇欲坠的。这种带着微妙戏谑意味的修辞框定,或许是一种从项目伊始就对承诺加以缓冲的方式;它既是在管理预期,也是在承认:无论是研究构想还是其执行,都是在一片相当不稳固的地基上展开的。
在二十一世纪第三个十年的这个“AI 之夏”里,计算机视觉与机器视觉的新进展(尤其是在生成式人工智能领域)似乎已经抛弃了这种修辞上的谦逊或限定,至少乍看之下如此。这一点在 Stability AI 的旗舰产品上体现得最为明显:那个得名为 Stable Diffusion(稳定扩散)的文生图生成模型。然而,公司名称与其 AI 模型都明确否认了任何摇晃或摇摆不定的成分,而与这种否认形成制衡的,是该模型纳入了一个特质截然不同的修辞形象:扩散(diffusion)。更重要的是,扩散不仅处于 Stability AI 模型的核心,也处于其主要竞争对手的模型的核心:Midjourney 公司的 Midjourney(这个产品名的字面意思就是“旅程中途”,即“我们尚未抵达”)、谷歌的 Imagen、Adobe 的 Firefly,以及 OpenAI 的 DALL·E 2。
审视用于描述 AI 模型的隐喻,可能看上去像是一种傲慢的人文学科式做派:企图仅仅在修辞层面上贬损一个复杂的计算机科学项目,而不去真正把握支撑它的实际技术。我们稍后确实会讨论扩散的技术面向。但值得先停下来承认一点:对于科学与工程如何被框定、被表述并被投射向未来而言,隐喻至关重要,它们不仅是装饰性的,而且是操演性的(performative)。马修·科布(Matthew Cobb)认为,隐喻“处于科学家思维方式的核心”[103]:科学观点部分地由当下占主导地位的技术概念所塑造,而这些概念反过来又开始为科学提供灵感——不仅用于描述科学,还用于践行科学。科布甚至声称,隐喻和类比实际上能够改变科学家“理解自身工作的方式,甚至使他们能够设计出新的实验”[103]。当前横跨神经科学与计算机科学的主导隐喻,是作为计算机的大脑——一个据称像差分机那样处理数据的器官;它取代了此前用来解释知觉的摄影“印记”(imprinting)与电影“放映卷片”(showreel)。随后,AI 研究中又启动了进一步的隐喻循环:机器学习的计算过程(包括生成式的过程)被表述为依循与人脑相同的原理运作——产生幻觉(hallucinating)、做梦、建立出人意料的联结。而正是在这个层层嵌套的隐喻结构中,“扩散”这一形象携带着它全部的流动性与摇摆不定,渗透了进来。
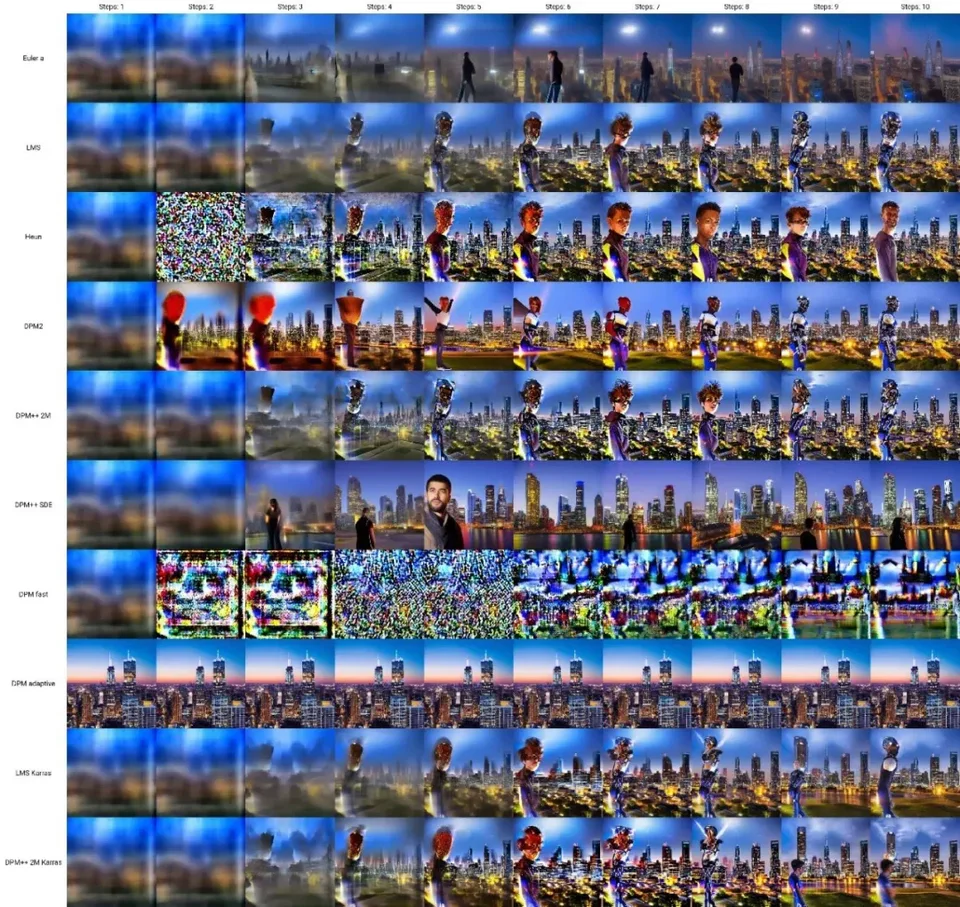
“扩散”这一术语借自热力学[40],指的是一种物质在另一种物质中缓慢溶解的过程。而在计算机科学的领域里,这两种“物质”都相当地缺乏实体:它们是数据,且以噪声为起点。换言之,通过扩散过程生成一幅影像,就是取一幅随机的噪声影像,然后经由若干次迭代步骤,以统计的方式将这些噪声“溶解”或移除,以期最终得到一幅所欲对象的影像。噪声的去除使用一种概率采样方法,即一种计算每一步应去除多少噪声的数学程序。这种“所欲之物”通常由用户以言辞加以描述(写在提示词中),但该描述也可以与一幅影像相配合。影像的生成是先前训练阶段的逆转:在训练阶段,噪声(称为高斯噪声或随机噪声)被分成多个阶段、逐渐添加到一幅影像之上。
负熵的希望
将扩散与噪声安置于核心——不仅作为修辞手段,也作为数学与技术实践——这件事就观看世界的方式而言,告诉了我们什么?如果说我们此前指出的是对象与影像之间的认识论鸿沟,那么在这里,我们抵达的是某种流动性大得多的东西:不稳定性,成为了我们的世界图像赖以涌现的组织性概念与技术。的确,从根本上不稳定的不仅是对影像的知觉,还有影像自身的构成,因为这种构成以一系列(技术的、文化的与经济的)操作为前提;经由这些操作,马歇尔·伯曼(Marshall Berman)在其著作标题《一切坚固的东西都烟消云散了》(All That Is Solid Melts into Air, 1982)中所包含的现代性批判,被在字面意义上实现了。[83] 伯曼的分析指出了“传统世界”的一切确定性的液化,同时也为现代主义的流动性提供了一种马克思主义的矫正,以便将资本与社会之流重新导向一个更具进步性的方向。这种情绪与思考方式,已被当代的马克思主义 AI 批评者们接续下来。例如,大卫·格伦比亚(David Golumbia)认为,生成式 AI 建立在“关于人类、创造力和意义究竟是什么的、非常黑暗且具有毁灭性的观念”之上,他将这项事业等同于虚无主义,并认为它“直接”通向法西斯主义。格伦比亚甚至宣称:“ChatGPT 和其他生成式 AI 程序本就不应存在。它们不是一个关心人类生命的人会去建造的那种东西”[104]。他将“人类意义”及关心它的人,与那些隔着生成式 AI 弥散的烟雾和镜面幻象而看不见其中法西斯主义的人对立起来,把人类与 AI 的关系视为一场只能有一方获胜的生存之战。与此类似,技术批评家帕里斯·马克思(Paris Marx)宣称,“生成式 AI 关闭了通向更好未来的大门”[105]。由于生成模型“只能拿取已经存在的东西”[42],它们无法生产出真正新颖的事物,无论是在影像的层面还是在想象力的层面。
与其对格伦比亚和帕里斯·马克思的批评作字面化的解读(然后又过快地将其斥为过于片面、过于不加批判的人文主义),或许我们可以去审视并接续他们各自论证背后的那种情绪(sentiment)——顺带一提,这恰恰是生成式 AI(暂且)无法做到的事情。这样,我们便能在他们对生成式 AI 的严厉抨击中,看到一种针对人类与自然资源之剥削的强有力的道德批判。我们也可以从中辨认出一种政治性的诉求:一种对更好、更公平的世界的渴望——一个不被过度膨胀的资本及其大科技公司主人所拖累的世界——以及一种为“属于多数人而非少数人”的、充满可能性的未来而工作的意愿。作为对格伦比亚和帕里斯·马克思的批评所作的这种更宽厚的“情绪解读”的一部分,同样值得承认的,是那些已然存在的研究工作:关于 AI 政治经济学的研究;关于劳动问题的研究,以及在一个艺术已被降格为无休止生产无意义产出的社会中、文化事业如何被赋值的研究;不仅针对偏见、也针对某些算法技术应用所促成的“政治红线划定”(political redlining)与更深层不公的批判;还有对运行这些技术所需付出的生态代价的研究[45][69][24]。
然而,在不放弃这种进步性渴望的前提下,我们能否越过“人类对抗机器”的二元论,转而接受这样一种可能:这些(以及其他)技术并不是某种正在降临到我们头上的东西?如果智能不仅在机器之中、而且在人类之中都是人造的,如果我们作为人类主体,本就是经由技艺(tékhnē)——工具、衣物、居所、传播——而共同涌现的,那么“生成式 AI 只能拿取已经存在的东西”这一陈述,就不必被视为对这项技术的控诉,而可以被看作对其物质性的一种实事求是的确认。不过,这条进路要行得通,前提是我们准备好接受一种纠缠的、跨尺度的思维方式,一种有能力将细胞层面、分子层面与量子层面纳入考量的思维(即便不必在同一时刻、以同一套支应结构 [affordances] 来处理每一种情形)。而这正是本文的论点:如果我们想要为生成式 AI(或许还是与生成式 AI 一道)创造一种更好的进步愿景,一种不被其资助者(或者其批评者)的短期表述所锁死的愿景,我们就确实需要后面这种承认。这一愿景所要求的,是一种少一些道德主义、少一些宣言姿态的理解——不仅是对艺术和其他人类创造性实践形式的理解,也是对“理解”本身的理解。
而这样一种许诺,或许恰恰可以在“扩散”概念、及其被应用于机器视觉之中的“摄影式观看”这一底层理念中去寻求。在 Midjourney 或 Stable Diffusion 这样的生成式影像模型中,扩散是熵——即系统朝向信息均质化的退化——的典型形象。然而,当一幅新的影像从噪声中、或者说从“稀薄的空气”中被生成出来时,训练层面的熵便经历了一个负熵的(negentropic)逆转过程。由于 AI 技术的黑箱化,这一时刻在人类观察者面前的呈现方式,带有某种神秘的、近乎魔法的色彩——观察者们无法观察到这一过程的大部分。但这场正在展开的转变的更广阔语境,连同其多重的变化层次,无论从科学、技术还是文化的角度来看,都值得注意。正如本文开篇所提示的,尽管我们的出发点是考察在几个关键的文生图生成模型中被实际实现的扩散技术,“扩散”这一概念也可以被解读为一种更深层趋势的象征:一种朝向不稳定性、朝向物质与资金耗散的趋势——它虽未被明言,却被内建于所有的生成式 AI 系统之中(包括那些实际架构中并不包含扩散模型的系统),也内建于它们所共同构成的更广泛的媒介生态之中。这一趋势将特征提取与语义压缩用作前文讨论过的“平均化原则”的一部分,由此带来了另一种意义上的扩散:诸如种族或性别这样“在政治上具有显著意义的人类概念”的消解(dissolution),以及它们随后作为“非历史的、非政治的、非意识形态的”概念的重新构成[47]。
在科学之中,熵这一概念的使用经历了一场旅行:从热力学——在那里它指物质与能量的逐渐耗散,最终导向系统的热寂——到信息论——在那里,高熵代表着低信息价值、不确定性与混沌。及至 1980 年代,信息论已深入社会科学和更广泛的社会思考之中;正是在这一时期写作的维兰·弗鲁塞尔(Vilém Flusser)调动了这一概念,去探究它的潜能——不仅是毁灭性的潜能,还有解放性的潜能。我们在这里再次触及隐喻作为变革推动者在不同学科领域之间穿行的作用,只不过这一次,是人文学者——哲学家、媒介理论家——在从科学中借用观念,来表述他们关于世界、以及为了世界的愿景。弗鲁塞尔在他对传播与创造力的解读中援引了熵的概念[15]——在他看来,传播与创造力总是发生在一个更大的社会技术装置的格局之内,但它们也包含着一种负熵的倾向。在《论传播理论》(‘On the Theory of Communication’, 2002b)一文中,他举了大学讲座的例子:讲座是熵性的,因为它是一个自然的热力学过程,其间一个系统(听众)被另一个系统(讲者,后者经由教室空气这一介质向前一系统传送声波)所改变。能量逐渐转化为热,熵因此增加。但他同时也认出了这一事件的文化面向:信息(在知识的意义上)在第一个系统中增加了,从而在这间教室内实现了一种负熵的倾向——尽管这种倾向只有对那些能领会该信息之意义的观察者而言,才是可辨认的。弗鲁塞尔清楚,“从更长远来看,装置的自主性”终将压过人类朝向解放的努力,走向热寂[37]。然而,他感兴趣的是那些可能的中断时刻:在这些时刻,负熵(或曰“赋形” [form-giving])[110]可以经由一个麦克斯韦妖(Maxwell’s demon)[84]的行动而被实现,从而哪怕只是暂时地阻滞或转移这一进程。
我们在此求助于弗鲁塞尔,不仅因为他能帮助我们在扩散过程的内部辨认出一种反向力量,还因为在对抗熵性状况这件事上,他在传播系统之中赋予了摄影一个独一无二的位置。作为一位未有其名、先具其实的(avant la lettre)批判后人类主义者,弗鲁塞尔清楚地意识到,在宇宙中展开的种种更大进程,对人类的尺度是漠不关心的。然而,恰恰是这个特定的人类尺度——连同其历史性的理解模式、意义生成模式与人工物创造模式——对他而言至关重要。为了从技术系统内部寻求一种解放的许诺,他指向了“赋形者”(in-formers),即那些为世界之混沌赋予形式的人;在他看来,正是这些行动者,有能力对宇宙的、以及我们皆身处其中的技术装置的大尺度进程,作出有意义的干预。在弗鲁塞尔那里,被认为尤其能够担当这一角色的是摄影师,因为他视他们为有能力打破习惯的人——习惯乃是“物理学中‘熵’在美学上的对应物”[32]——从而以不同的方式去观看、去行动。当然,并非每一个配备了摄影装置(相机、扫描仪或影像处理软件)的人都能做到这一点:弗鲁塞尔非常清楚,习惯化的进程无处不在,支配着人类文化活动的一切形式,从思考到影像制作皆是如此。然而,正是这种“另辟蹊径”(possibility of doing things otherwise)的可能性,在一场看似被预先决定的机运游戏——一场由“一种不断趋向无形式的根本倾向”[35]所驱动的游戏——之中,开辟出了一个缺口。弗鲁塞尔认为,照片“是被有意生产出来的负熵簇。负熵可以被称为‘信息’。从形式意识的视角来看,照片是从一群彼此孤立的可能性中被有意生产出来的信息”[106]。它们是潜在的反扩散装置——即便它们当下所被投入的语境,往往制造出的是混乱与混沌。到 2024 年初,Stability AI 已耗尽其巨额储备金,无法获得足够的追加融资,“拖欠了亚马逊的款项,而正是后者的云服务支撑着 Stability 的核心产品”[19],失去了其研究团队的大部分成员,并罢免了创始人兼 CEO 埃马德·莫斯塔克(Emad Mostaque)——这一事实充分说明了这个为新未来建模的产品背后所潜藏的更广泛的问题。曾许诺要“直面重大的敌手——癌症、自闭症乃至时间之沙本身”的 Stable Diffusion,最终落入了“一个深坑”,不知如何爬出[19]。
新可视化(New Visualisation)
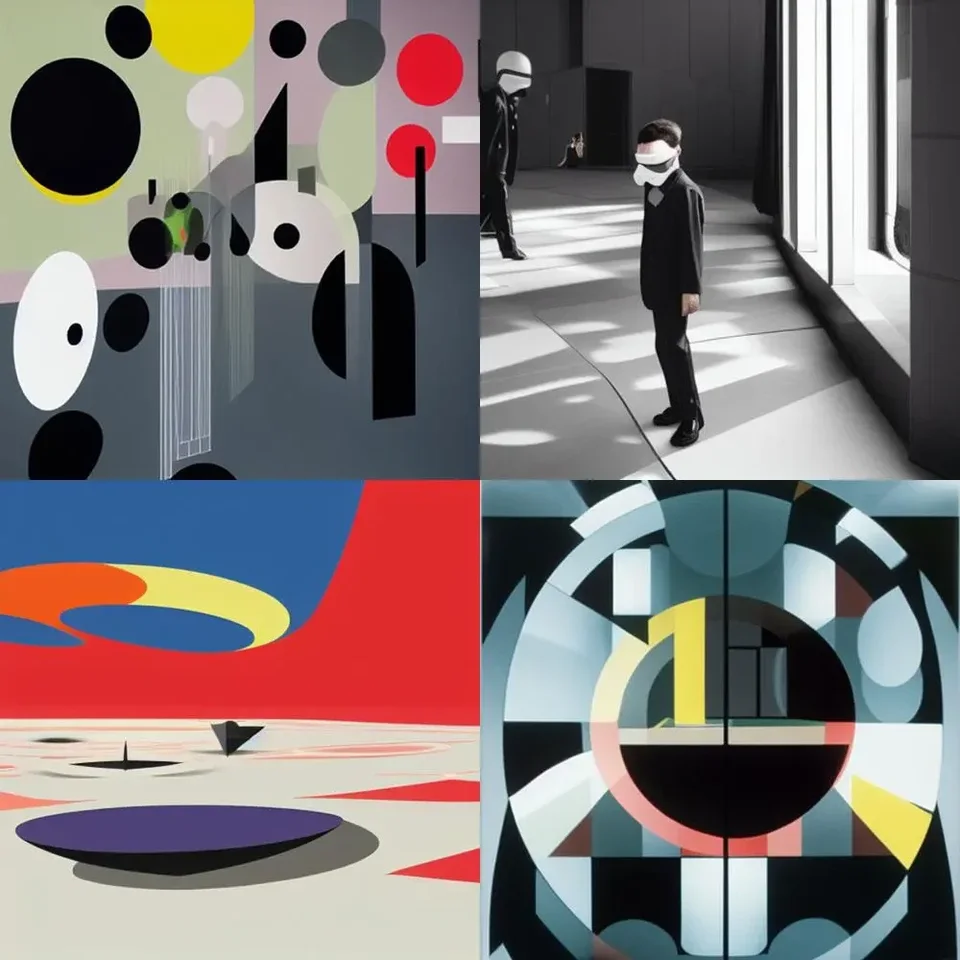
弗鲁塞尔关于摄影的最重要的文本写于 1980 年代,那不过是影像制作之数字化转型时代的一个黎明时分。然而对他来说,意向性从来都是系统性的,而非纯粹人类的。照片因此是将人类及其装置一并卷入其中的技术力量被激活之后的产物,而不仅仅是人类意图的产品。今天,摄影影像与其生产、流通过程之间——以及与参与其中的能动者之间——的关系已被显著改变:我们所面对的局面,不仅是大多数摄影影像的制作不再以人类观看者为预设对象,而且我们常常难以区分一幅摄影影像和一幅看起来像照片、实则由生成式 AI 模型生产出来的合成影像。然而,这种关于摄影影像之本体论的不确定性,自摄影媒介诞生之初便已存在,灵异摄影(spirit photography)、先锋派摄影蒙太奇和数字照片处理都是其明证。
正如本文通篇所论证的,摄影在今天的存续,不仅是作为一种记忆,也是作为 AI 数据库的结构化技术——以及一种面向未来成像的创造性力量。转述杰弗里·巴钦[7]的说法①,我们可以说,摄影存续于一种对摄影的欲望之中,即便那被调动起来去具现这一欲望的技术,已不再完全以光为基础。萨尔瓦乔提出,由 Stable Diffusion、Midjourney 或 DALL·E 2 这样的生成模型所产出的影像,在本体论和技术的意义上都不是照片,而是可视化(visualisations),或曰信息图(infographics);它们是“被铭写进图片之中的数据模式”[51]。然而,我们也应记得早先那些恰恰将摄影定义为“可视化的引擎”[107]的说法:正是这段历史,使托斯特以更明确的计算术语重新命名了摄影媒介——“‘可视化的程序’,或者更简单地说,‘一台可视化图灵机’”[108]。托斯特的论证是弗鲁塞尔式的,因为他认出了弗鲁塞尔在摄影媒介中辨识出的那种生成的可能性。在弗鲁塞尔看来,照片是“被计算出来的可能性(模型,向环境的投射)”[35],因为它们以点状元素的演算及其后续的计算为前提。弗鲁塞尔的论证针对的是模拟摄影,但它同样适用于他称之为“技术影像”(technical images)的其他形式:数字摄影,以及各种后摄影(after-photographic)影像。照片是可视化的形象,而非想象(imagination)的形象(因为它们并不要求人从环境中抽身出来,“以便为环境创造一幅影像”),它们有能力将“一群可能性变为一幅影像”[106]。可视化,是弗鲁塞尔给予“从可能性之中凝结出一幅影像的力量”[106]的命名,它使一种向未来的投射——同时也是对未来的投射——成为可能。
正是在这个意义上,我们可以将一切种类的技术影像——包括由生成式 AI 生产的那些——理解为未来的可能载体:未来的意义、未来的方案、未来的生命的载体。当然,没有什么能保证那个未来将是什么样子:保证它将是进步的而非法西斯的、滋养生命的而非剥削性的。但正是在技术影像固有的组合可能性之中,我们得以寻求马克思主义人文主义的哀悼式忧郁——以及大科技公司的狂乱乐观主义——之外的替代方案(图 5)。而正是在那种重新进行可视化的欲望之中,在拼装出关于正义与政治的另类的(哪怕是摇摇晃晃的)愿景的欲望之中,我们能够找到一种慰藉:即,未来终究存在。
参考文献
[1] Amerika, M. (2007) META/DATA: A Digital Poetics. Cambridge, MA: MIT Press.
[2] Amerika, M. (2022) My Life as an Artificial Creative Intelligence. Stanford, CA: Stanford University Press.
[3] Amerika, M. (2022) My Life as an Artificial Creative Intelligence. Stanford, CA: Stanford University Press. 引用位置:4。
[4] Azar, M., G. Cox, & L. Impett (2021) ‘Introduction: Ways of Machine Seeing’, AI & Society 36: 1093–1104, https://doi.org/10.1007/s00146-020-01124-6.
[5] Baio, A. (2022) ‘Exploring 12 Million of the 2.3 Billion Images Used to Train Stable Diffusion's Image Generator’, Waxy, August 30, https://waxy.org/2022/08/exploring-12-million-of-the-images-used-to-train-stable-diffusions-image-generator/.
[6] Barthes, R. (1977) ‘The Photographic Message’ in Image, Music, Text. London: Fontana Press, pp.15-31.
[7] Batchen, G. (1997) Burning with Desire: The Conception of Photography. Cambridge,
[8] MA: MIT Press.
[9] Bender, E. M., T. Gebru T, A. McMillan-Major & S. Shmitchell (2021) ‘On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?’. Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency; FAccT. Association for Computing Machinery: 610– 623. DOI: 10.1145/3442188.3445922
[10] Berger, J. (1972) Ways of Seeing. London: British Broadcasting Corporation and Penguin Books.
[11] Berger, J. (1972) Ways of Seeing. London: British Broadcasting Corporation and Penguin Books. 引用位置:10。
[12] Berger, J. (1980) ‘Uses of Photography’, in About Looking. New York: Pantheon Books, pp.48-63.
[13] Berger, J. (1980) ‘Uses of Photography’, in About Looking. New York: Pantheon Books, pp.48-63. 引用位置:50。
[14] Berman, M. (1982) All That Is Solid Melts into Air: The Experience of Modernity. London and New York: Verso.
[15] Booten, K. (2020) ‘Flusser’s Demon: Writing Under the Eye of an Automatic Critic’. Flusser Studies 30, Vilém Flusser and His ‘Languages’ (November): 1-20.
[16] Braidotti, R. (2013) The Posthuman. Cambridge: Polity.
[17] Bunz, M. (2019) ‘The Calculation of Meaning: On the Misunderstanding of New Artificial Intelligence as Culture’, Culture, Theory and Critique, 60: 3-4, 264-278, DOI: 10.1080/14735784.2019.1667255.
[18] Bunz, M. (2019) ‘The Calculation of Meaning: On the Misunderstanding of New Artificial Intelligence as Culture’, Culture, Theory and Critique, 60: 3-4, 264-278, DOI: 10.1080/14735784.2019.1667255. 引用位置:273,强调为原文所加。
[19] Cai, K. & I. Martin (2024) ‘How Stability AI’s Founder Tanked His Billion-Dollar Startup’, Forbes, Mar 29, https://www.forbes.com/sites/kenrickcai/2024/03/29/how-stability-ais-founder-tanked-his-billion-dollar-startup/
[20] Chávez Heras, D. & T. Blanke (2021) ‘On Machine Vision and Photographic Imagination’, AI and Society 36: 1153–1165.
[21] Chávez Heras, D. & T. Blanke (2021) ‘On Machine Vision and Photographic Imagination’, AI and Society 36: 1153–1165. 引用位置:1155。
[22] Cobb, M. (2020) The Idea of the Brain: The Past and Future of Neuroscience. London: Profile Books, Kindle edition.
[23] Cole, D. (2023) ‘The Chinese Room Argument’, The Stanford Encyclopedia of Philosophy, E. N. Zalta and U. Nodelman (eds.), https://plato.stanford.edu/archives/sum2023/entries/chinese-room/.
[24] Crawford, K. (2021) The Atlas of AI: Power, Politics, and the Planetary Costs of Artificial Intelligence. New Haven: Yale University Press.
[25] Danziger, S., J. Levav & L. Avnaim-Pesso (2011) ‘Extraneous Factors in Judicial Decisions’, PNAS, 108(17): 6889-6892, https://doi.org/10.1073/pnas.1018033108
[26] Daston, L. & P. Galison (2010) Objectivity. New York: Zone Books.
[27] Dewdney, A. (2021) Forget Photography. London: Goldsmiths Press.
[28] Dobson, J. E. (2023) The Birth of Computer Vision. Minneapolis: University of Minnesota Press.
[29] Dobson, J. E. (2023) The Birth of Computer Vision. Minneapolis: University of Minnesota Press. 引用位置:138。
[30] Fausto-Sterling, A. (2000) Sexing the Body: Gender Politics and the Construction of Sexuality. New York: Basic Books.
[31] Flusser, V. (2002a) ‘Habit: The True Aesthetic Criterion’, in Writings, ed. A. Ströhl, trans. E. Eisel. Minneapolis: University of Minnesota Press, 51-57.
[32] Flusser, V. (2002a) ‘Habit: The True Aesthetic Criterion’, in Writings, ed. A. Ströhl, trans. E. Eisel. Minneapolis: University of Minnesota Press, 51-57. 引用位置:53。
[33] Flusser, V. (2002b) ‘On the Theory of Communication’, in Writings, ed. A. Ströhl, trans. E. Eisel. Minneapolis: University of Minnesota Press, 8-20.
[34] Flusser, V. (2002c) ‘Photography and History’, in Writings, ed. A. Ströhl, trans. E. Eisel. Minneapolis: University of Minnesota Press, 126-132.
[35] Flusser, V. (2002c) ‘Photography and History’, in Writings, ed. A. Ströhl, trans. E. Eisel. Minneapolis: University of Minnesota Press, 126-132. 引用位置:129。
[36] Flusser, V. (2011) Into the Universe of Technical Images. Minneapolis: University of Minnesota Press.
[37] Flusser, V. (2011) Into the Universe of Technical Images. Minneapolis: University of Minnesota Press. 引用位置:19。
[38] Golumbia, D. (2022) ‘ChatGPT Should Not Exist’, Medium, December 14, https://davidgolumbia.medium.com/chatgpt-should-not-exist-aab0867abace
[39] Ho, J., A. Jain & P. Abbee (2020) ‘Denoising Diffusion Probabilistic Models’, pp.1-25, arXiv preprint arxiv:2006.11239.
[40] Ho, J., A. Jain & P. Abbee (2020) ‘Denoising Diffusion Probabilistic Models’, pp.1-25, arXiv preprint arxiv:2006.11239. 引用位置:1。
[41] Malevé, N. & K. Sluis (2023) ‘The Photographic Pipeline of Machine Vision; or, Machine Vision's Latent Photographic Theory’, Critical AI 1 (October), 1 (1-2). DOI: https://doi.org/10.1215/2834703X-10734066
[42] Marx, P. (2023) ‘Generative AI Closes Off a Better Future’, Disconnect, September 1, https://www.disconnect.blog/p/generative-ai-closes-off-a-better
[43] Mitchell, M. & D. C. Krakauer (2023) ‘The Debate over Understanding in AI’s Large Language Models’, PNAS 120 (13) e2215907120, March 21, https://doi.org/10.1073/pnas.2215907120
[44] Moholy-Nagy, L. (2003) ‘A New Instrument of Vision’, in L. Wells, ed., The Photography Reader. London and New York: Routledge, pp.92-96. Originally published in 1936.
[45] Noble, S. (2018) Algorithms of Oppression: How Search Engines Reinforce Racism. New York: New York University Press.
[46] Offert, F. & T. Phan (2022) ‘A Sign That Spells: DALL·E 2, Invisual Images and The Racial Politics of Feature Space’, arXiv:2211.06323.
[47] Offert, F. & T. Phan (2022) ‘A Sign That Spells: DALL·E 2, Invisual Images and The Racial Politics of Feature Space’, arXiv:2211.06323. 引用位置:3。
[48] Paglen, T. (2016) ‘Invisible Images (Your Pictures Are Looking at You)’, New Inquiry,
[49] December 8, https://thenewinquiry.com/invisible-images-your-pictures-are
[50] -looking-at-you/.
[51] Salvaggio, E. (2022) ‘How to Read an Image: The Datafication of a Kiss’, Cybernetic Forests Substack, October 2, https://cyberneticforests.substack.com/p/how-to-read-an-ai-image
[52] Searle, J. R. (1980) ‘Minds, Brains, and Programs’, Behavioral and Brain Sciences 3 (3): 417-457. [Preprint, accessed via Cogprints, 1-19.]
[53] Sekula, A. (1975) ‘On the Invention of Photographic Meaning’, Artforum, 13:5 (January): 36-45.
[54] Sekula, A. (1975) ‘On the Invention of Photographic Meaning’, Artforum, 13:5 (January): 36-45. 引用位置:37。
[55] Singer, P. (1997) ‘The Drowning Child and the Expanding Circle’, The New Internationalist, April 5, https://newint.org/features/1997/04/05/peter-singer-drowning-child-new-internationalist
[56] Sontag, S. (2005 [1973]) On Photography. New York: Rosetta Books with Farrar, Straus & Giroux.
[57] Sontag, S. (2005 [1973]) On Photography. New York: Rosetta Books with Farrar, Straus & Giroux. 引用位置:1。
[58] Toister, Y. (2020) Photography from the Turin Shroud to the Turing Machine. Bristol: Intellect.
[59] Toister, Y. (2020) Photography from the Turin Shroud to the Turing Machine. Bristol: Intellect. 引用位置:3。
[60] Wasielewski, A. (2023a) ‘Authenticity and the Poor Image in the Age of Deep Learning’, photographies, 16:2, 191-210, DOI: 10.1080/17540763.2023.2189158.
[61] Wasielewski, A. (2023a) ‘Authenticity and the Poor Image in the Age of Deep Learning’, photographies, 16:2, 191-210, DOI: 10.1080/17540763.2023.2189158. 引用位置:195-196。
[62] Wasielewski, A. (2023b) ‘“Midjourney Can’t Count”: Questions of Representation and Meaning for Text-to-Image Generators’, Image: The Interdiscipinary Journal of Image Sciences, 37: 19(1): 71-82, DOI: 10.1453/1614-0885-1-2023-15454.
[63] Wasielewski, A. (2023b) ‘“Midjourney Can’t Count”: Questions of Representation and Meaning for Text-to-Image Generators’, Image: The Interdiscipinary Journal of Image Sciences, 37: 19(1): 71-82, DOI: 10.1453/1614-0885-1-2023-15454. 引用位置:73。
[64] Wasielewski, A. (2023b) ‘“Midjourney Can’t Count”: Questions of Representation and Meaning for Text-to-Image Generators’, Image: The Interdiscipinary Journal of Image Sciences, 37: 19(1): 71-82, DOI: 10.1453/1614-0885-1-2023-15454. 引用位置:78。
[65] Wells, L. (2003) ‘Photographic Seeing’, in L. Wells, ed., The Photography Reader. London and New York: Routledge, pp.82-85.
[66] Wells, L. (2003) ‘Photographic Seeing’, in L. Wells, ed., The Photography Reader. London and New York: Routledge, pp.82-85. 引用位置:92。
[67] Wolfe, C. (2009) What Is Posthumanism? Minneapolis: University of Minnesota Press.
[68] Zylinska, J. (2017) Nonhuman Photography. Cambridge, MA: MIT Press.
[69] Zylinska, J. (2020) AI Art: Machine Visions and Warped Dreams. London: Open
[70] Zylinska, J. (2020) AI Art: Machine Visions and Warped Dreams. London: Open 引用位置:52-55。
[71] Humanities Press.
[72] Zylinska, J. (2023) The Perception Machine: Our Photographic Future between the Eye and AI. Cambridge, MA: MIT Press.
[73] Zylinska, J. (2023) The Perception Machine: Our Photographic Future between the Eye and AI. Cambridge, MA: MIT Press. 引用位置:in the style of Moholy-Nagy New Vision。
注释
[74] 在认知心理学中,“看见”在传统上被界定为加诸主体身上的一种生理过程,而“知觉”则被视为主体与世界之间一种更为复杂且更具能动性的交互形式,涉及对所接收数据的阐释。约翰·伯格的《观看之道》(Ways of Seeing, 1972)——视觉过程研究领域的人文学者之关键文本——主张这些过程彼此不可分割地交织在一起,从而反对那种存在先于文化的原初“观看方式”的观念。本文沿着伯格的思想路径,提出“看见”本身已然是一种知觉形式,因为数据分析与阐释的过程自始便被调动于整个知觉矩阵之中,而该矩阵不仅包含主体的视觉与认知装置,还囊括了主体身体之外的一整套行动者、连接关系与制度结构——这一情形同时适用于人类与机器(参见 Azar 等,2021)。关于知觉与观看交织关系的论证已在《知觉机器》(The Perception Machine,Zylinska, 2023)中得到展开;本文则是在该著作基础上的进一步延伸,将这一论证带入新的技术与概念领域。
[75] 在许多此类模型中,“扩散”与变换器及 GANs 协同运作(例如通过 VQGAN 与 CLIP 等网络)。谨此致谢匿名审稿人,协助我更清晰地表述本句及下一句中的相关论点。
[76] 马莱韦与斯吕斯解释道:“尽管很少以此方式被表述,机器视觉在历史上一直依赖一系列摄影实践(例如对摄影影像的构图、拍摄、标注与分类),并构建了一整套复杂的影像筛选、整理与处理流程,将数以百万计摄影师与知觉主体的劳动转译为数据集”(2023)。
[77] “过多细节可能会使每一张影像彼此差异过大,从而不足以进行概括化。因此,在分类任务中,降采样影像往往比高细节影像表现更佳”(Wasielewski, 2023a: 198)。
[78] 在用于训练 Stable Diffusion 的 LAION 数据集中,人类亦参与了所谓“预测属性”的赋值过程(Malevé & Sluis, 2023;亦参见 Baio, 2022),例如为每张影像标注审美评分或是否可能包含水印等概率。
[79] 这一思路呼应了哲学家约翰·塞尔于 1980 年提出的“中文屋”。塞尔设想了这样一种情境:他坐在一间封闭的房间里,手中收到一批中文文本,以及一套用英文写成的指令(某种计算机程序版本),指导他如何将某些中文符号与形状相互对应。由此,尽管塞尔本人并不懂中文,却能够对从门缝下递入的中文对话提示给出看似合理的中文回应,却并不知道自己在说什么。然而,这一情境仍然欺骗了门外的人类观察者,使其误以为自己正在与一位真正理解并使用中文的对象交流——在此情形下,这个对象正是塞尔本人,他将自己描述为“只是计算机程序的一种实例化”(1980: 3)。
[80] 正因如此,彼得·辛格关于我们对溺水儿童之责任的功利主义寓言(1997),与分析哲学中许多基于抽象案例的测试情境一样,并不能完全成立。
[81] 在其作品一贯体现的混编(remix)精神之下,阿梅里卡在此处引述了他早先的著作《META/DATA:一种数字诗学》。
[82] 除了凸显这一术语在概念上的不稳定性之外,这种加连字符的拼写方式(Un-Stable)还旨在将本文所阐述的立场,与一个名为“Unstable Diffusion”的 AI 色情影像生成器区分开来。
[83] 这一说法原出自卡尔·马克思与弗里德里希·恩格斯的《共产党宣言》。
[84] 凯尔·布滕(Kyle Booten)解释道:“麦克斯韦妖是一种在物理的热力学系统内部抵抗熵的算法或‘机器人程序’(bot)。弗鲁塞尔的直觉是双重的:其一,批评家们同样以类似的方式,充当着在文化系统中抵抗熵的妖式过滤器;其二,这一功能可以由‘自动批评家’来自动化地执行,后者依据某种语言学标准对文本进行过滤”(2020, 4)。
[85] 巴钦(1997)将十九世纪末多种摄影发明的爆发,归因于一种对摄影的“渴望”(desire)的存在。这种欲望体现在人们对保存影像之能力的广泛兴趣之中,同时也受到技术基础设施之充分发展的推动,正是这些基础设施使那些摄影发明成为了可能。(译注:按巴钦《热切的渴望》所论时段实为十八世纪末至十九世纪初,原文“the close of the nineteenth century”疑为笔误,此处照原文译出。)
[89] Wolfe, 2003; Braidotti, 2013.
[90] Wells, 2003, 82–84.
[91] Sontag, S. (2005 [1973]) On Photography. New York: Rosetta Books with Farrar, Straus & Giroux. 引用位置:18。
[92] Berger, J. (1980) ‘Uses of Photography’, in About Looking. New York: Pantheon Books, pp.48-63. 引用位置:53;原文强调。
[93] Azar, M., G. Cox, & L. Impett (2021) ‘Introduction: Ways of Machine Seeing’, AI & Society 36: 1093–1104, https://doi.org/10.1007/s00146-020-01124-6.
[94] Li 2019.
[95] Toister, Y. (2020) Photography from the Turin Shroud to the Turing Machine. Bristol: Intellect. 引用位置:4。
[96] Paglen, 1996; Dewdney, 2021; Toister, 2021.
[97] Wasielewski, A. (2023b) ‘“Midjourney Can’t Count”: Questions of Representation and Meaning for Text-to-Image Generators’, Image: The Interdiscipinary Journal of Image Sciences, 37: 19(1): 71-82, DOI: 10.1453/1614-0885-1-2023-15454. 引用位置:78。
[98] Wasielewski, A. (2023b) ‘“Midjourney Can’t Count”: Questions of Representation and Meaning for Text-to-Image Generators’, Image: The Interdiscipinary Journal of Image Sciences, 37: 19(1): 71-82, DOI: 10.1453/1614-0885-1-2023-15454. 引用位置:79–80。
[99] Wasielewski, A. (2023b) ‘“Midjourney Can’t Count”: Questions of Representation and Meaning for Text-to-Image Generators’, Image: The Interdiscipinary Journal of Image Sciences, 37: 19(1): 71-82, DOI: 10.1453/1614-0885-1-2023-15454. 引用位置:73。
[100] Wasielewski, A. (2023b) ‘“Midjourney Can’t Count”: Questions of Representation and Meaning for Text-to-Image Generators’, Image: The Interdiscipinary Journal of Image Sciences, 37: 19(1): 71-82, DOI: 10.1453/1614-0885-1-2023-15454. 引用位置:71。
[101] Mitchell, M. & D. C. Krakauer (2023) ‘The Debate over Understanding in AI’s Large Language Models’, PNAS 120 (13) e2215907120, March 21, https://doi.org/10.1073/pnas.2215907120
[102] Dobson, J. E. (2023) The Birth of Computer Vision. Minneapolis: University of Minnesota Press. 引用位置:139。
[103] Cobb, M. (2020) The Idea of the Brain: The Past and Future of Neuroscience. London: Profile Books, Kindle edition.
[104] Golumbia, D. (2022) ‘ChatGPT Should Not Exist’, Medium, December 14, https://davidgolumbia.medium.com/chatgpt-should-not-exist-aab0867abace
[105] Marx, P. (2023) ‘Generative AI Closes Off a Better Future’, Disconnect, September 1, https://www.disconnect.blog/p/generative-ai-closes-off-a-better
[106] Flusser, V. (2002c) ‘Photography and History’, in Writings, ed. A. Ströhl, trans. E. Eisel. Minneapolis: University of Minnesota Press, 126-132. 引用位置:129。
[107] Toister, 2021, 8;转引 Maynard.
[108] Toister, 2021, 8.
[109] Berger, J. (1980) ‘Uses of Photography’, in About Looking. New York: Pantheon Books, pp.48-63. 引用位置:63。
[110] Flusser, V. (2002b) ‘On the Theory of Communication’, in Writings, ed. A. Ströhl, trans. E. Eisel. Minneapolis: University of Minnesota Press, 8-20. 引用位置:20。
译者注
① 译注: enact 这个词我之前在 Karen Barad 的文章中翻译成“具现”,理由如下:enact/enactment 在英文词典中的解释是“to perform a play or act a part in a play", 和 performance 有明显的语义关联性;“具”有其物质性含义,而“现”则可指现象生成;若翻译成“施行”等则有“固定”之嫌,翻译成“演出”则太过 anthropocentric,因此考虑之下姑且翻译为“具现”。
② 译注:《圣经·马可福音》 5:9 中有如下句:“My name is Legion: for we are many.”(和合本译为——耶稣问他说:“你名叫什么?”回答说:“我名叫‘群’,因为我们多的缘故。”) 塞库拉说的是“一个人”指着照片;而作者的意思是,在今天的大数据时代,这个“人”不再是单个的个体,而是变成了千千万万的互联网用户和数据标注员。
③ 译注:这里的“中庸”是意译,原文“Goldilocks principle”