返回课程目录
专题课程

人工智能之后的艺术与影像

从人工智能的基本原理到创造力、影像伦理与世界模型,形成自己的判断。

课程内容 8 讲授课教师陈国森课程形式线上课程
人工智能之后的艺术与影像课程海报

课程介绍

课程从机器学习、神经网络和视觉语言的技术基础出发,讨论 AI 的理解能力、影像真相与信任、创造力、判断力及世界模型。技术讲解与哲学分析相互衔接,帮助我们具体理解生成影像及围绕它展开的艺术讨论。

课程内容

从数据到智能:机器学习与神经网络基础

From Data to Intelligence: Machine Learning and Neural Networks
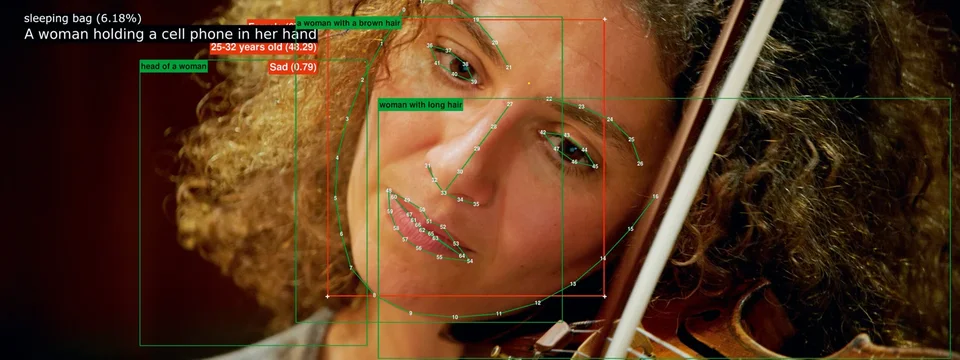
特雷弗·帕格伦,《Image Operations, Op. 10》,2018年。
特雷弗·帕格伦,《Image Operations, Op. 10》,2018 年。

这是一门关于人工智能与影像艺术的课程,但头两次课几乎全是技术性的。之所以这样安排,是因为如果我们不知道一台机器在什么意义上“学习”、在什么条件下会失败,那对它作出的哲学判断和美学判断就很容易越界。康德留给我们的一个重要启示是,思想需要知道自己的限度;划定边界不是放弃追问,恰恰是为了保护那些真正重要的追问。

这节课从一个具体问题开始:一台机器拿到一张手写数字的图片,它怎么判断上面写的是 0 还是 1?图片首先要被转化为一串数字,机器再通过反复比对预测与正确答案之间的差距来调整自身参数,逐渐逼近一个能够正确分类的函数。但经典理论告诉我们,模型复杂度超过某个临界点后就会把噪声也当规律记下来,于是面对新数据时表现急剧变差。今天的大语言模型拥有数十亿乃至数万亿参数,照理说应当严重失败,事实却恰恰相反:它们自发展现出从未被明确要求的能力,同时又会在我们毫无防备的地方给出彻底错误的回答。为什么“大”会有用,为什么它同时又以这种方式失败,至今没有公认的解释。我希望这节课能为后面讨论 AI 与影像提供一种经过足够技术细节的积累才可能形成的直觉。

像素与词义:机器学习的视觉与语言

Pixels and Word Meanings: Vision and Language in Machine Learning
特雷弗·帕格伦,通过高倍望远镜拍摄的内华达州开放机库。

上节课我们讲了机器怎样处理图像:一张图片无论有多少像素,总归是一个二维网格,网格中的像素彼此相邻,可以很自然地用连续数字表示。语言却完全不同。像素亮度 127 和 128 只差一个单位,但“猫”和“狗”之间没有这种连续关系;更麻烦的是,同一个“苹果”可以指水果,也可以指一家公司。如果我们想让神经网络处理语言,第一个问题就是怎样把词变成机器能够运算的数字。这节课的核心是 Word2Vec 所启发出的一个非常巧妙的思路。语言学家弗斯在 1957 年说过,一个词的意思由它经常和什么词一起出现来决定。如果两个词总是出现在相似的上下文中,它们大概率意思相近。这意味着语义可以被还原为一种统计规律,而统计规律恰恰是神经网络擅长从数据中学习的东西。Word2Vec 的天才之处在于,它并没有直接告诉网络哪些词彼此相似,而是给了网络一个预测任务;网络为了完成预测,不得不自行发展出一套编码语义的方式。最终我们要的不是预测结果本身,而是网络为了完成预测而学到的那些中间表示。这个“副产品”思路,对于理解后面几节课要讨论的许多问题至关重要。

限度与谬误:如何思考 AI 及其造物?

Limits and Fallacies: How Should We Think about AI and Its Creations?
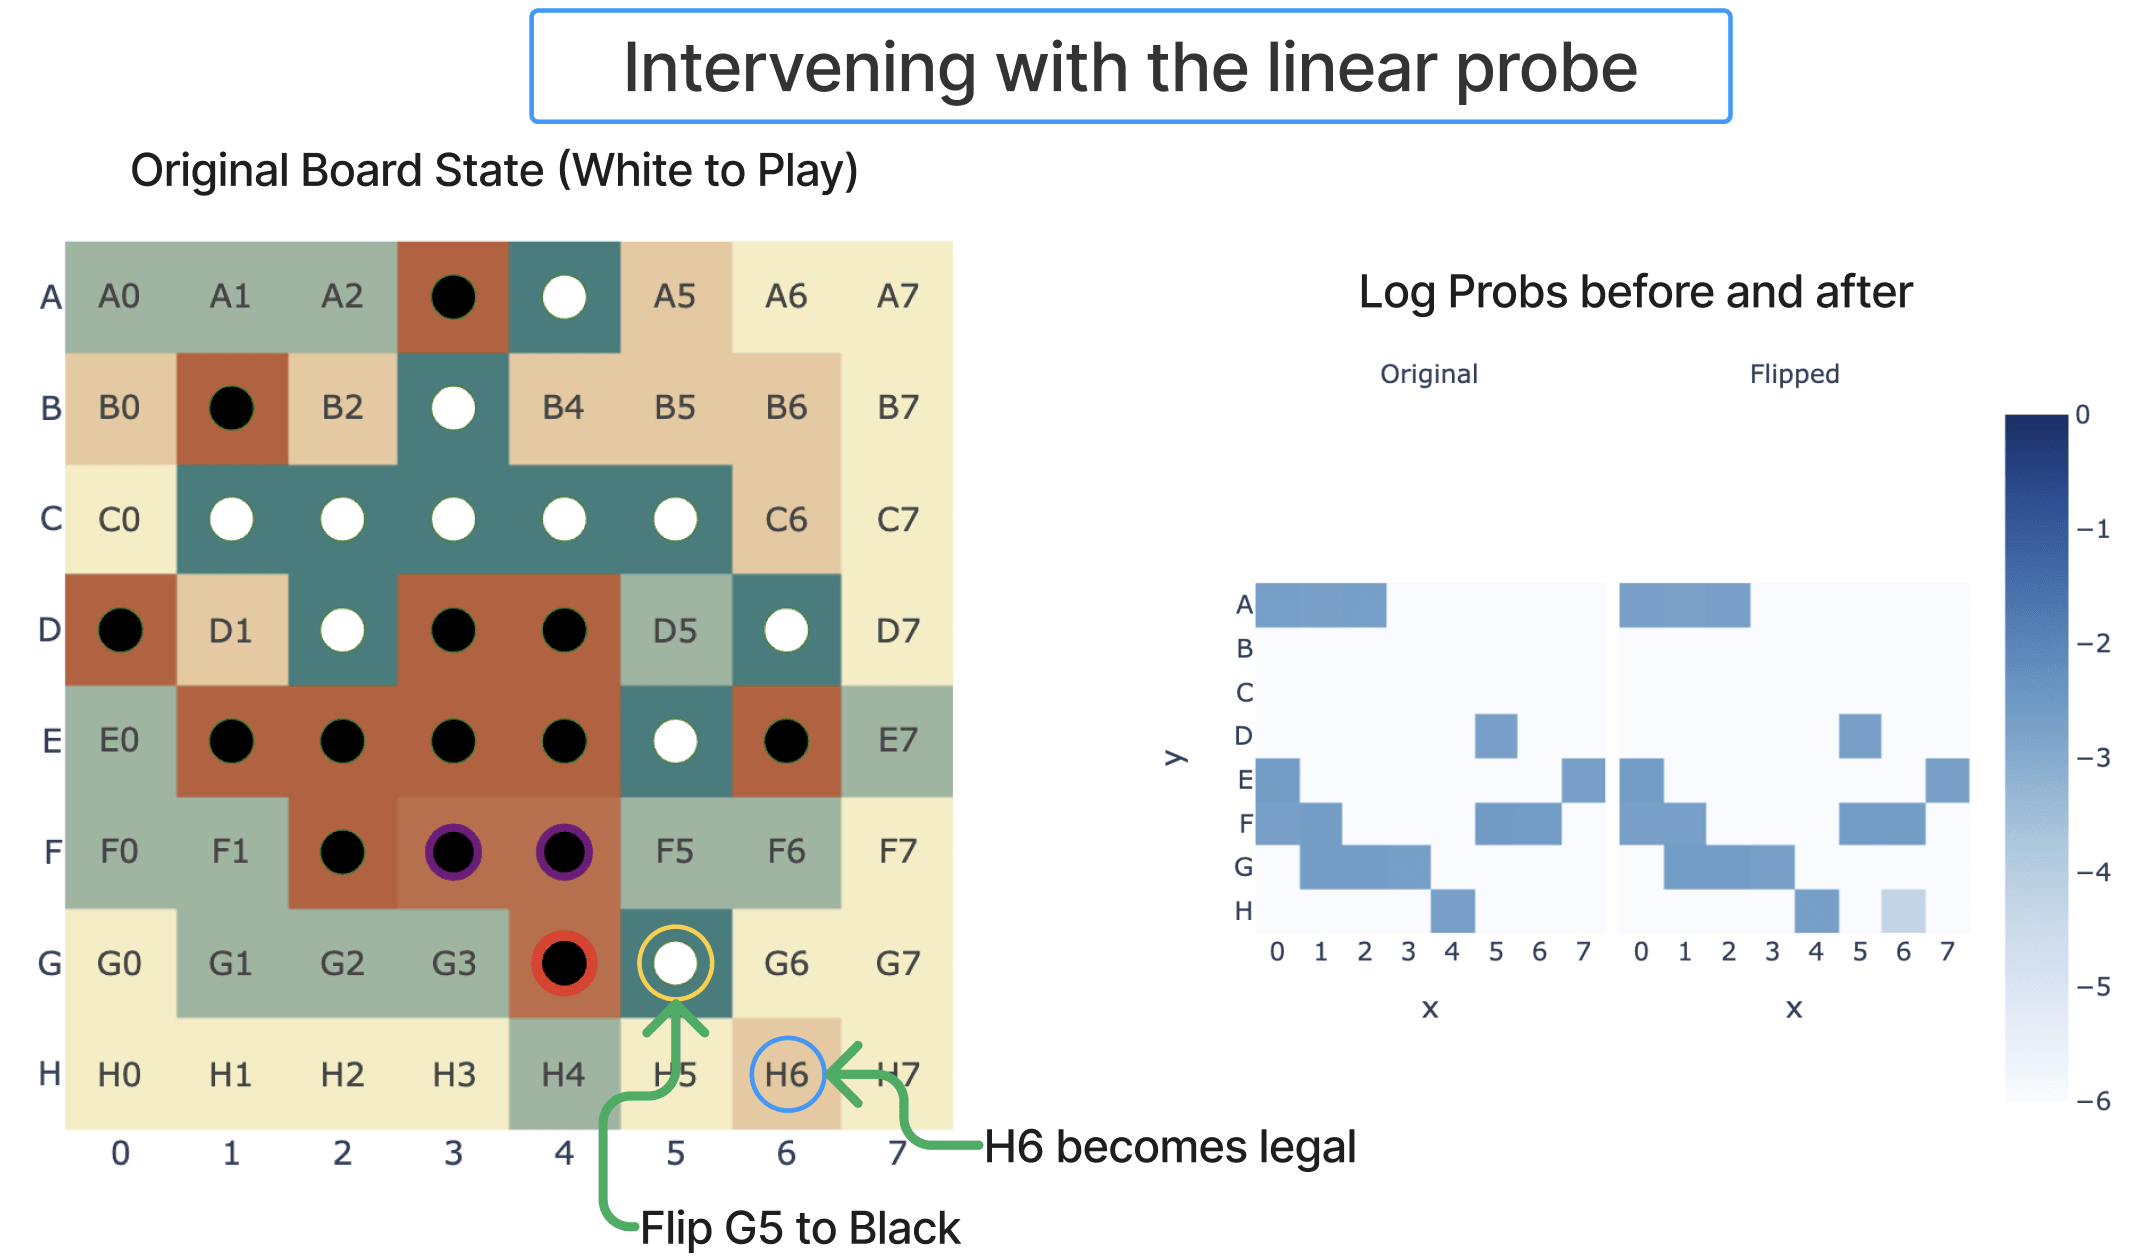
Othello-GPT:改变模型内部对应的棋子状态,观察下一步落子预测的变化。
Othello-GPT:通过干预内部表征,考察模型对棋盘状态的编码。

我们大概都有过这样的经历:有时候跟大语言模型聊一个相当复杂的问题,它给出的回应好到让人觉得它真的听懂了我在说什么;但有时候让它比较两个小数的大小,或者修一个简单的 bug,它的回应又总是让人不知如何是好。面对这种反差,一种流行的解释是:AI 本质上只是在做概率预测,所以不可能真正理解任何东西。这句话在技术描述上什么都没说错,但问题出在那个“所以”上。一个系统的训练目标是概率预测,是否意味着它学到的一切也只是概率预测?我们在前两节课专门讲 Word2Vec,就是为了在这里提供一个反例:一个被设计去做预测的系统,为了完成预测而自发发展出了训练目标从未明确要求的能力。这两节课会借助几个实验来检验这个问题。其一是 Othello-GPT:研究者让一个 Transformer 仅仅通过棋谱序列学习下棋,从未告诉它棋盘长什么样,它却在内部自发构建出了一个与真实棋盘对应的世界模型,并且确实在使用这个模型进行预测。当然,棋盘是一个规则完全确定的封闭系统,自然语言远比它复杂。但这些实验至少迫使我们正视一个事实:在“它只是在做概率预测”和“它真正理解了”之间,存在着大片尚未被认真清理的地带。与此同时,我也会讨论围绕 AI 生成影像的一些批评概念,看看哪些批判经得起推敲,哪些则在技术描述与价值判断之间跳跃得过于轻率了。

影像与信任:AI 之后的摄影真相问题

Images and Trust: Photographic Truth after AI
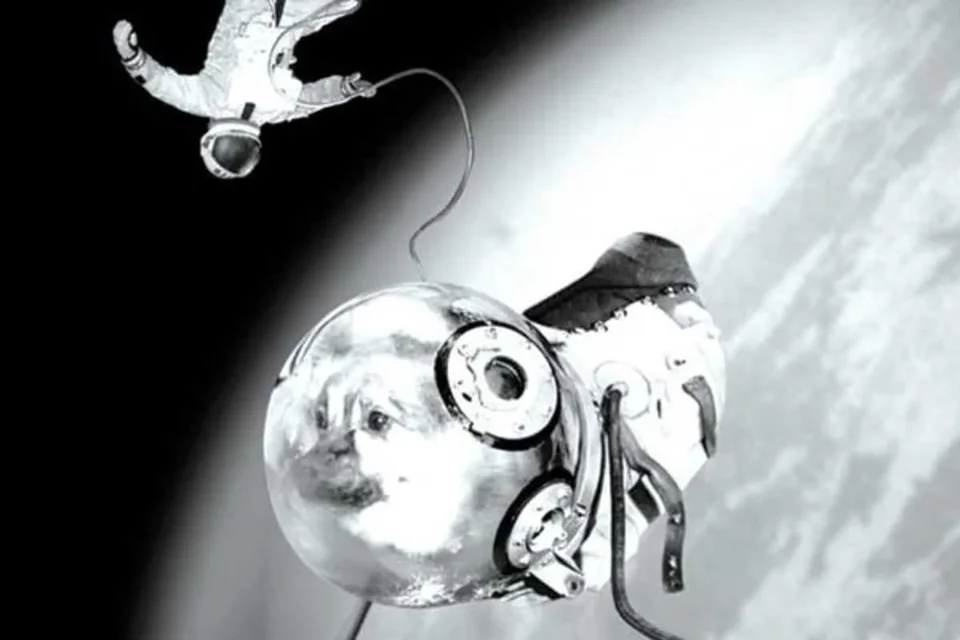
琼·丰特库贝尔塔,《Sputnik》,1997年。
琼·丰特库贝尔塔,《Sputnik》,1997 年。

我们现在大概都经历过这样的时刻:在社交媒体上看到一条离谱的消息,第一反应是怀疑它是不是 AI 生成的。可是反过来,在朋友圈里刷到朋友的照片时,我们似乎不太会有同样的怀疑。这个差异的背后有一个更深的问题:相比文字,我们为什么总是倾向于给予照片更大的信任?即使在 AI 生成影像已经如此逼真的今天,这种信任也没有被轻易取消。皮尔斯有一个说法叫做“附带知识”:在我们接收到一个符号之前,已经有一整套背景知识在帮助我们解读它了,很多时候我们甚至意识不到它的存在。从 1839 年至今将近两百年的影像文化,培养了我们关于影像、真相和事实之间关系的附带知识。以前信任照片是一个经济上理性的选择,因为造假成本极高,假图像在全部影像中的占比被压得很低。但如果 AI 让造假成本趋近于零,这个信任结构会发生什么变化?我们通过影像发现经验边界之外的事情,为之震动甚至愤怒,而这一切的前提正是信任。这节课想要梳理的,就是这种信任的根据,以及这些根据在今天正在经历怎样的变化。

技术哲学的工作:论人工智能的创造力

Philosophy of Technology: On the Creativity of Artificial Intelligence
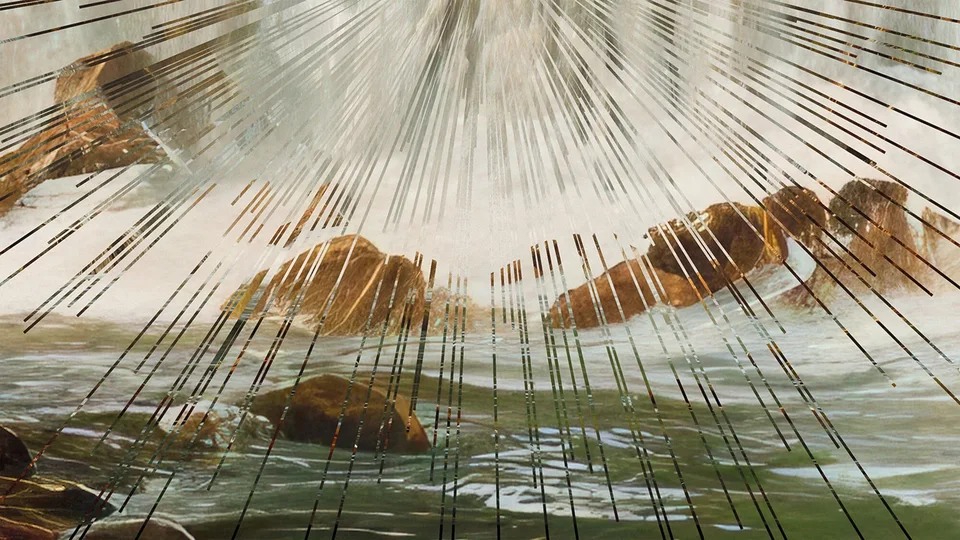
霍莉·赫恩登与马特·德赖赫斯特,《Starmirror》,2025年;设计:Patricia Klein。
霍莉·赫恩登与马特·德赖赫斯特,《Starmirror》,2025 年;设计:Patricia Klein。

2022 年,杰森·艾伦用 Midjourney 生成的图像在科罗拉多州博览会的数字艺术比赛中获得一等奖,引发了广泛的愤怒。人们的不满似乎来自一个直觉:这个人没有亲手把作品做出来。但如果我们稍微想一想,艺术史上并非由艺术家亲手完成的作品多了去了。杜尚没有制作那个小便池,约翰·凯奇的《4 分 33 秒》几乎什么也没有演奏,但它们都构成了二十世纪的艺术事件。所以亲手制作从来都不是艺术价值的必要条件,我们的不适一定另有来源。这节课真正要讨论的不是艾伦做了什么,而是他使用的那个 AI 做了什么。我们为什么下意识地觉得 AI 生成的东西不具备真正的创造力?这个直觉也许站得住脚,也许站不住脚,但总需要一个根据。我会借助许煜和梅洛-庞蒂对塞尚的讨论来逼近这个问题。塞尚把同一座山画了几十遍,想捕捉一个连自己都说不清楚的东西,一直到死都不觉得达到了完成的境界。这种持续几十年的追求,能不能在画面中留下痕迹?这种痕迹是否属于一种不可计量的领域,而我们的审美感受力恰恰能够触及它?

判断力问题:《康德机器》与道德能力

The Problem of Judgment: Kant Machine and Moral Capacity
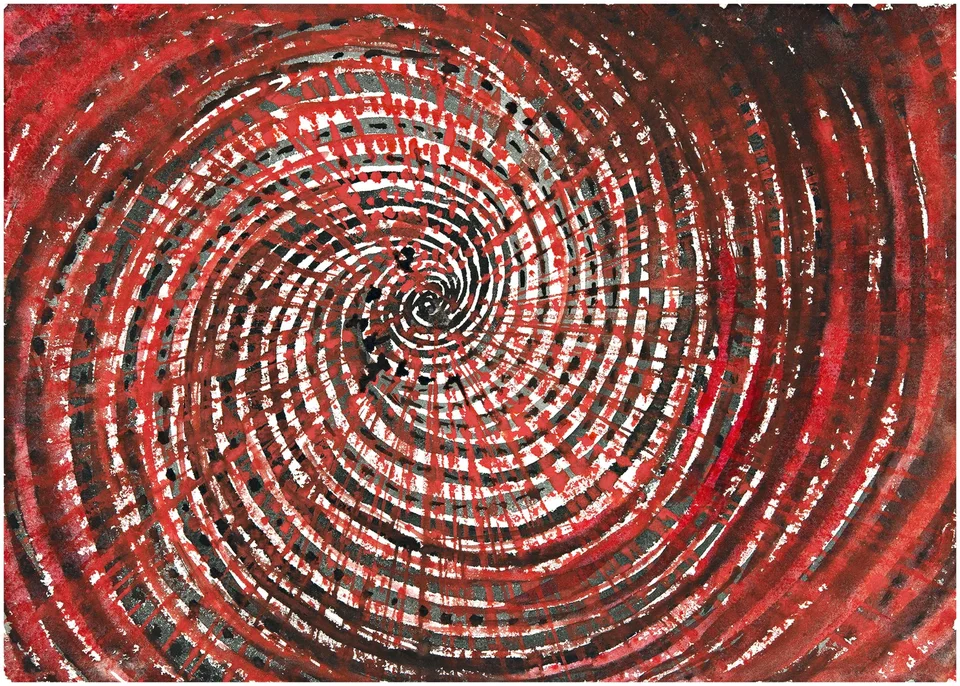
希尔玛·阿芙·克林特,《无题》,1922年。
希尔玛·阿芙·克林特,《无题》,1922 年。

本节课的问题起源于一个案例:有人在社交媒体上发了莫奈晚年画的《睡莲》真迹,告诉观众这是 AI 生成的,请大家评价它为什么不如莫奈的原作。评论区里有大量的人认真分析了这幅“AI 作品”的缺陷:色彩选择不对、景深不协调、画面生硬、无法触动情感。后来博主公布说这就是莫奈的真迹。这件事当然很有喜剧效果,但我不太同意那种轻快的结论,即人类根本没有判断力,不过是被标签蒙蔽了双眼。问题比这复杂得多。这节课的主线是许煜的《康德机器》。许煜试图借助康德的批判哲学来标定 AI 的能力边界,他最终的论点是:AI 原则上不可能拥有道德能力。这里的“原则上”意味着无论 AI 再怎么发展,这一点都不会改变,因为道德属于一个他称之为“不可估量”的领域,在范畴上就不属于计算的领地。但这个论证面临着一个我认为相当严峻的挑战:如果我们承认 AI 可以从简单的训练目标出发涌现出远超预期的能力,我们凭什么确信它不会继续生长下去?许煜对此的回答,以及这个回答最终在多大程度上依赖于一个无法进一步论证的价值判断,是我想和大家一起辨析的。

世界模型:一种关于理解的构想

World Models: A Conception of Understanding
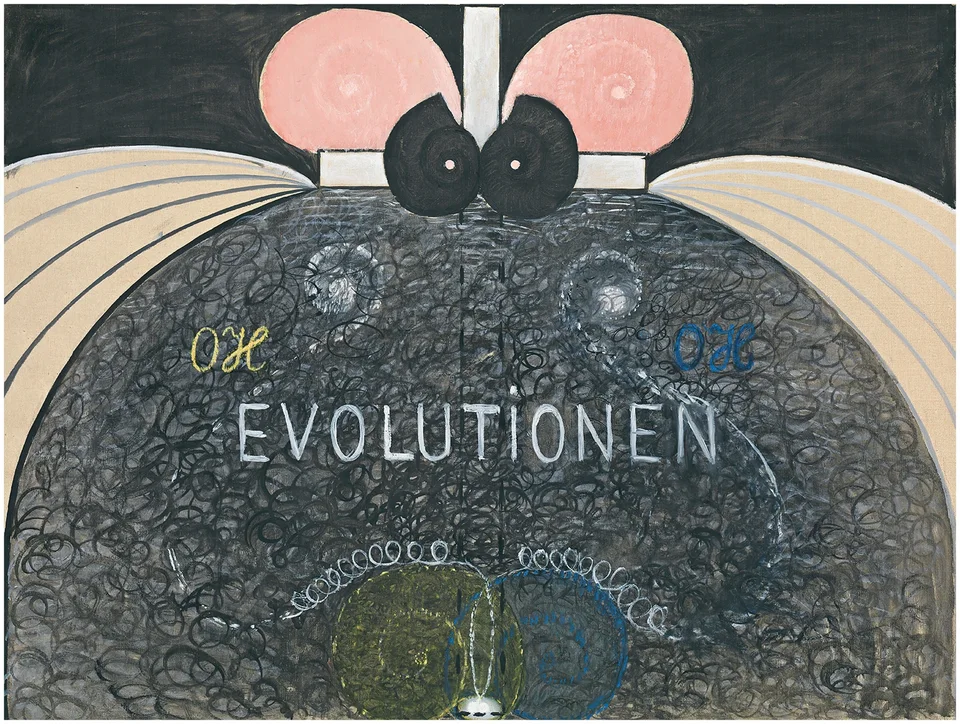
希尔玛·阿芙·克林特,《进化,第7号》。
希尔玛·阿芙·克林特,《进化,第 7 号》。

前面几节课我们讨论了 AI 是否“理解”、是否具有创造力和道德能力,这节课要进入一个更具体的技术构想:杨立昆提出的 JEPA。他认为当前 Transformer 架构有一个根本问题:处理连续的高维信号时,它必须预测一切细节,包括那些不值得预测的东西。比如一段驾驶视频,我们想知道的只是车往哪个方向走,Transformer 却要先把下一帧所有像素都预测出来,再从中提取答案。这是先预测、再理解。杨立昆想把顺序颠倒过来:先通过编码器把原始数据压缩为表征,过滤掉不相关的细节,再在表征层面做预测。对他来说,表征就意味着一种理解。但这个构想引出了一个很深的问题。1963 年的“小猫转盘实验”中,两只小猫接受了完全相同的视觉刺激,唯一的变量是一只能主动行走,另一只只能被动移动。结果只有主动行走的那只发展出了正常的视觉能力。知觉与行动似乎从根本上无法分开。而杨立昆设想的,恰恰是一个纯粹通过观察就能建立世界模型的系统,一个不参与任何事情却理解一切的旁观者。过去所有拥有世界模型的存在者同时也是行动者,是会受伤、会死亡的生物,所以从来没有人需要追问观察和行动各自起什么作用。JEPA 让这个问题第一次成为可以被单独检验的对象,而它反过来也让我们重新审视自身:行动、疼痛、有限性,对于理解而言究竟意味着什么。
参考文献

迈克尔·尼尔森. 深入浅出神经网络与深度学习[M]. 朱小虎,译. 北京:人民邮电出版社,2020.

王维嘉. 优美与崇高:康德的感性判断力批判[M]. 上海:上海三联书店,2020.

康德. 康德著作全集:第 5 卷:实践理性批判、判断力批判[M]. 李秋零,主编、译. 北京:中国人民大学出版社,2007.

康德. 道德形而上学的奠基[M]//康德著作全集:第 4 卷. 李秋零,译:393-472.

托马斯·福克斯. 脑:一个关系器官:一种现象学-生态学构想[M]. 王旭,译. 北京:商务印书馆,2025.

莫里斯·梅洛-庞蒂. 意义与无意义[M]. 张颖,译. 北京:商务印书馆,2018.

威廉·弗鲁塞尔. 摄影哲学的思考[M]. 毛卫东,丁君君,译. 北京:中国民族摄影艺术出版社,2017.

许煜. 艺术与宇宙技术[M]. 苏子滢,译. 上海:华东师范大学出版社,2022.

Azoulay, Ariella. Civil Imagination: A Political Ontology of Photography. Translated by Louise Bethlehem, paperback ed., Verso, 2015.

Crawford, Kate, and Trevor Paglen. “Excavating AI: The Politics of Images in Machine Learning Training Sets.” Excavating AI, AI Now Institute, 19 Sept. 2019.

Daston, Lorraine, and Peter Galison. Objectivity. Zone Books, 2007.

Firth, J. R. “A Synopsis of Linguistic Theory, 1930–1955.” Studies in Linguistic Analysis, Basil Blackwell, 1957, pp. 1–32.

Hui, Yuk. Kant Machine: Critical Philosophy after AI. Bloomsbury Academic, 2026.

LeCun, Yann. A Path Towards Autonomous Machine Intelligence. Version 0.9.2, 27 June 2022. OpenReview.

Li, Kenneth, et al. “Emergent World Representations: Exploring a Sequence Model Trained on a Synthetic Task.” International Conference on Learning Representations, 2023.

Mikolov, Tomas, et al. “Distributed Representations of Words and Phrases and Their Compositionality.” Advances in Neural Information Processing Systems, vol. 26, 2013, pp. 3111–19.

Mikolov, Tomas, et al. “Efficient Estimation of Word Representations in Vector Space.” arXiv, 2013, arXiv:1301.3781v3.

Minsky, Marvin, and Seymour Papert. Perceptrons: An Introduction to Computational Geometry. Expanded ed., MIT Press, 1988.

Nakkiran, Preetum, et al. “Deep Double Descent: Where Bigger Models and More Data Hurt.” arXiv, 4 Dec. 2019, arXiv:1912.02292v1.

Nanda, Neel, et al. “Emergent Linear Representations in World Models of Self-Supervised Sequence Models.” arXiv, 7 Sept. 2023, arXiv:2309.00941v2.

Peirce, Charles S. The Essential Peirce: Selected Philosophical Writings. Vol. 2, 1893–1913, edited by the Peirce Edition Project, Indiana University Press, 1998.

Roberts, John. Photography and Its Violations. Columbia University Press, 2014.

Rombach, Robin, et al. “High-Resolution Image Synthesis with Latent Diffusion Models.” arXiv, 13 Apr. 2022, arXiv:2112.10752v2.

Sekula, Allan. “The Body and the Archive.” October, vol. 39, 1986, pp. 3–64.

Shannon, C. E. “A Mathematical Theory of Communication.” The Bell System Technical Journal, vol. 27, nos. 3–4, 1948, pp. 379–423, 623–56.

Silver, David, et al. “Reward Is Enough.” Artificial Intelligence, vol. 299, 2021, article 103535.

Steyerl, Hito. Medium Hot: Images in the Age of Heat. Verso, 2025.

Steyerl, Hito. “In Defense of the Poor Image.” e-flux Journal, no. 10, Nov. 2009.

Turing, A. M. “On Computable Numbers, with an Application to the Entscheidungsproblem.” Proceedings of the London Mathematical Society, 2nd ser., vol. 42, no. 1, 1937, pp. 230–65.

Vaswani, Ashish, et al. “Attention Is All You Need.” Advances in Neural Information Processing Systems, vol. 30, 2017, pp. 5998–6008.

Zylinska, Joanna. “We Have Always Been Artificially Intelligent: An Interview with Joanna Zylinska.” Interview by Claudio Celis and Pablo Ortuzar Kunstmann. Culture Machine, vol. 20, 2021.

讲师介绍

陈国森

陈国森

陈国森,复旦大学哲学学院艺术哲学系博士候选人,“摄影理论避难所”社群联合创办者。主讲九季“摄影理论训练营”课程,参与者七百余人次。研究兴趣为摄影理论、现象学美学、人工智能伦理等。曾多次与斯蒂芬·肖尔(Stephen Shore)、杰夫·沃尔(Jeff Wall)、托马斯·鲁夫(Thomas Ruff)、夏洛特·科顿(Charlotte Cotton)等著名摄影师与学者展开对谈活动。业余从事摄影文献译介。有多篇中、英语论文见于 Photography and Culture,《二十一世纪》《南京艺术学院学报(美术与设计版)》《中国摄影》《法国哲学研究》《艺术工作》《文化艺术研究》等处。